 PGB&CompanyTech Blog
SAP 데이터 분석 에이전트 — 자연어를 질의문으로 번역하지 않고, 정해진 질의 중 하나를 고르게 한다
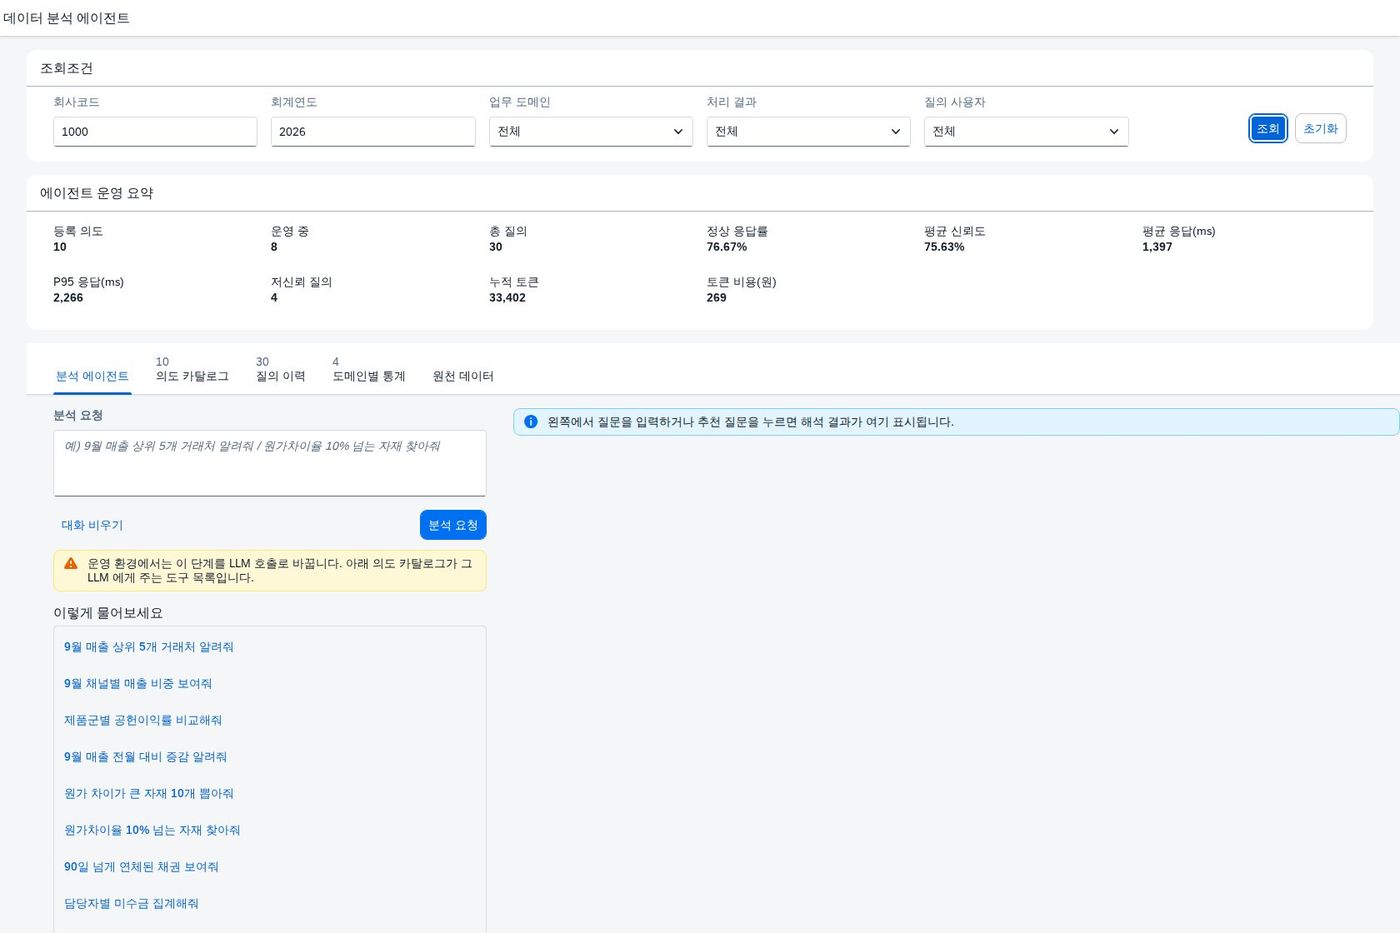
의도 카탈로그 · OData 질의 생성 · 집계 기반 분석 코멘트 · 토큰 비용 집계를 한 화면에서 확인합니다
"9월 매출 상위 5개 거래처 알려줘" 한 줄로 분석이 끝나면 좋겠지만, 자연어를 그대로 질의문으로 번역하게 맡기면 권한 밖의 데이터를 읽거나 조건이 슬쩍 달라지는 일이 생깁니다. 틀린 숫자를 그럴듯한 문장으로 받는 쪽이 더 위험합니다.
그래서 이 사례는 순서를 바꿨습니다. 쓸 수 있는 질의를 의도 카탈로그에 먼저 등록해 두고, 자연어 문장은 그중 하나를 고르는 데만 씁니다. 고른 뒤에는 등록된 OData 템플릿에 파라미터만 끼워 넣어 호출하고, 조회 결과를 집계해 분석 코멘트를 만듭니다. 코멘트의 숫자는 전부 조회 결과에서 계산한 값입니다. 질의 이력과 토큰 사용량까지 남겨 에이전트의 운영 상태를 함께 점검하는 화면을 OpenUI5 로 구현했습니다. 실제 구동 화면 9종을 함께 공개합니다.
| 항목 | 내용 |
|---|---|
| 업무 영역 | 관리회계(CO)·영업(SD)·재무회계(FI) — 자연어 분석 질의 |
| Namespace | zui5.dataagent |
| 셸 구조 | 단일 페이지 + 5개 탭 |
| 화면 수 | 메인 1 · 상세 다이얼로그 1 |
| SAP 표준 T-code | VA05 · S_ALR_87013611 · KKBC_HOE · FBL5N · F.35 |
| 데이터 연동 방식 | OData V2 (조회조건 전부 $filter, and 조건만) |
| 성격 | 자연어 해석 · 질의 생성 · 집계 · 운영 점검형 |
| 테마 | sap_horizon · 한국어 |
| 요약 | 내용 |
|---|---|
| 처리 흐름 | 자연어 문장 → 의도 선택 → 파라미터 추출 → OData 질의 생성 → 조회 → 집계 → 분석 코멘트 |
| 의도 카탈로그 | 10종 (영업·매출 3 · 원가·수익성 4 · 채권·자금 3), 운영 8종 |
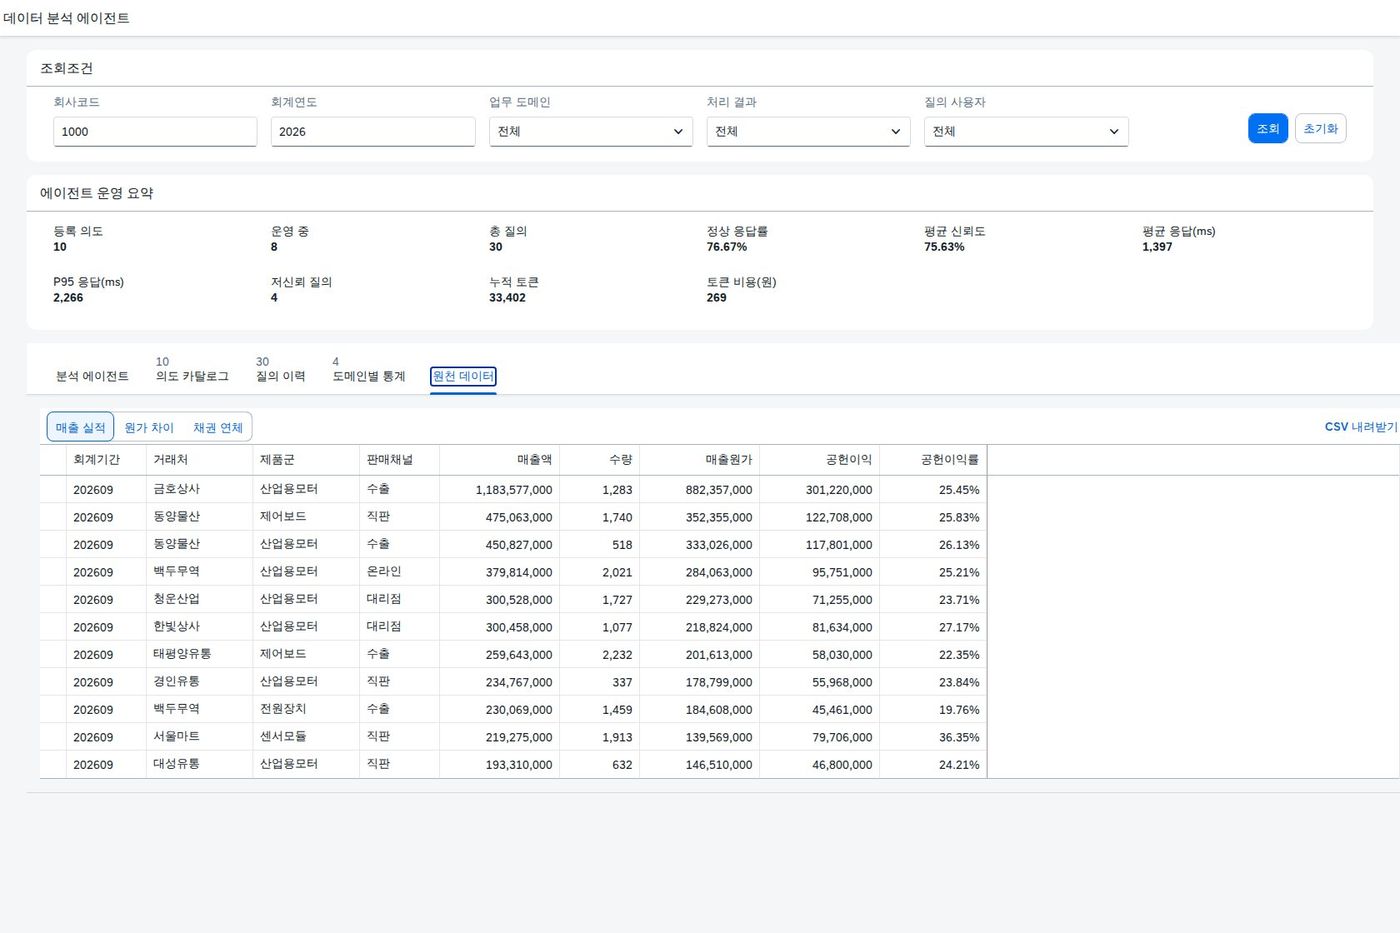
| 원천 데이터 | 매출 실적 249행 · 원가 차이 30행 · 채권 연체 41행 |
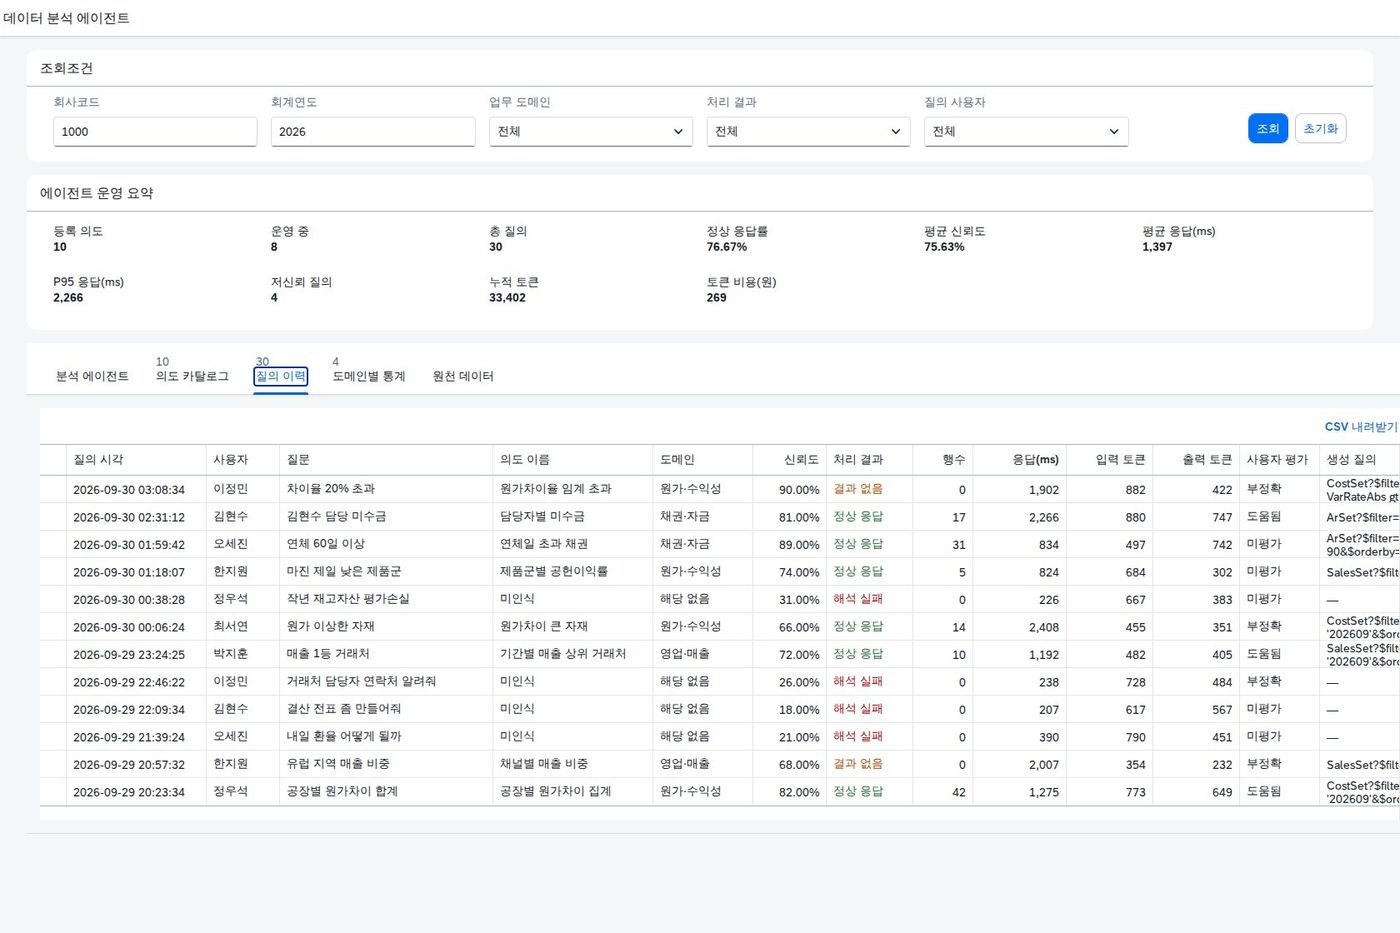
| 질의 이력 | 30건 — 정상 응답 23 · 결과 없음 3 · 해석 실패 4 (정상 응답률 76.67%) |
| 비용 집계 | 누적 33,402 토큰 · 269원 · 평균 신뢰도 0.7563 · 평균 응답 1,397ms · P95 2,266ms |
| 핵심 규칙 | 신뢰도 = min(0.98, 0.40 + 적합도 × 0.72) · 임계값 미달이면 질의를 만들지 않습니다 |
실제 화면 9종 둘러보기
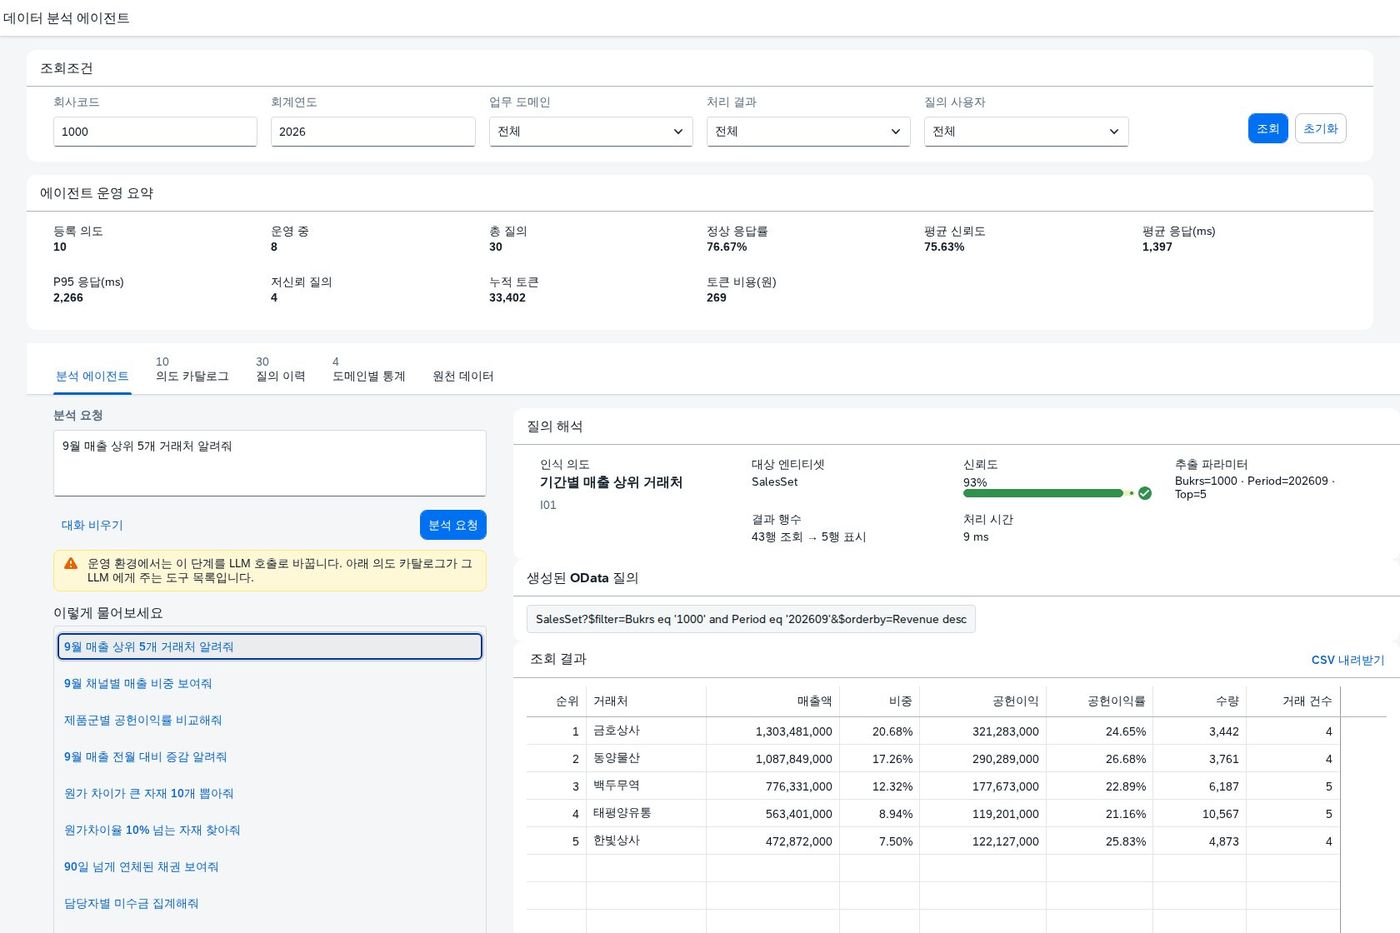
SalesSet?$filter=Bukrs eq '1000' and Period eq '202609'&$orderby=Revenue desc 를 호출합니다. 조회된 43행을 거래처별로 합산해 상위 5행으로 보여 줍니다.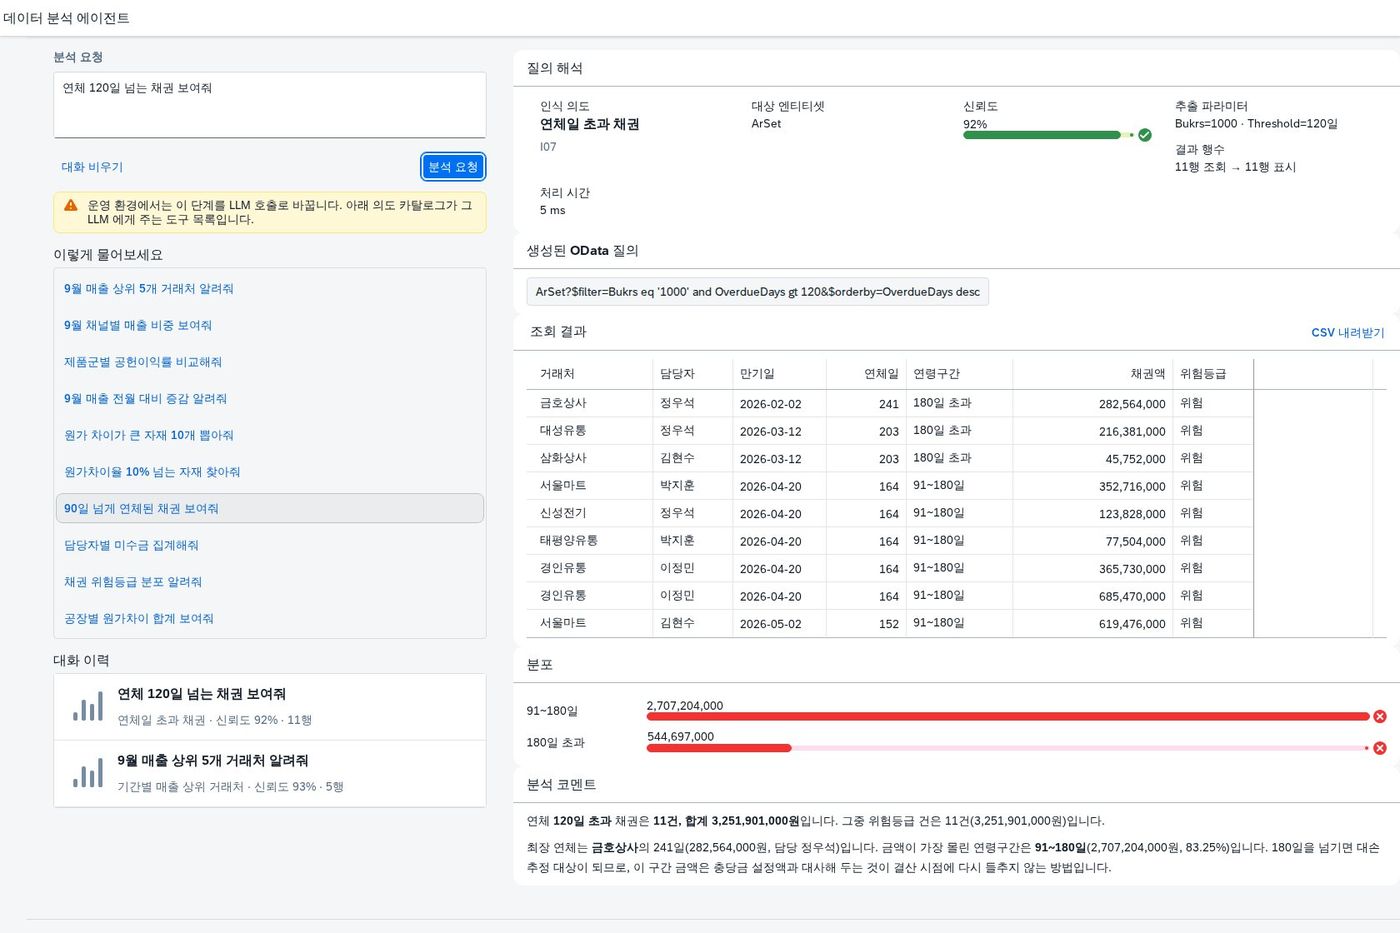
OverdueDays gt 120 으로 바꿉니다. 코멘트의 숫자는 모두 조회 결과에서 계산한 값입니다.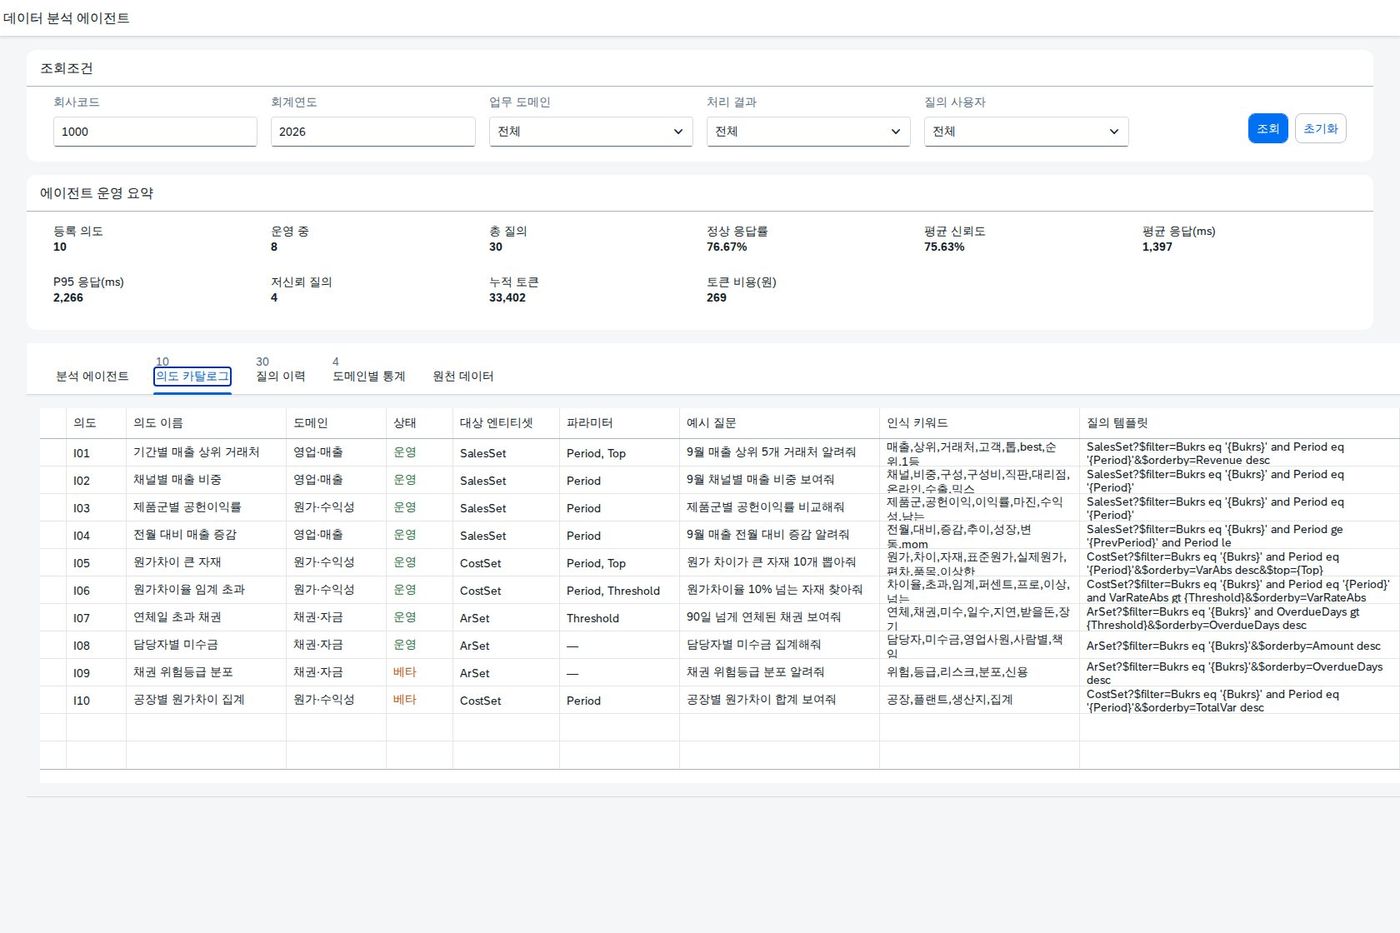
사용 방법
- 회사코드·회계연도를 넣고, 업무 도메인·처리 결과·질의 사용자는 필요할 때만 고릅니다. "전체"를 고르면 해당 조건 없이 조회됩니다.
- 조회 버튼은 조회조건 입력 필드 줄의 가장 오른쪽에 있습니다. 입력란에서 Enter 키를 눌러도 같은 조회가 실행됩니다.
- 요약 줄에서 등록 의도 수, 총 질의 건수, 정상 응답률, 평균 신뢰도, 평균·P95 응답시간, 누적 토큰과 비용을 먼저 확인합니다.
- 분석 에이전트 탭에서 추천 질문을 누르거나 직접 문장을 입력합니다. 해석된 의도와 신뢰도, 뽑아낸 파라미터, 생성된 OData 주소, 조회 결과와 분석 코멘트가 차례로 뜹니다.
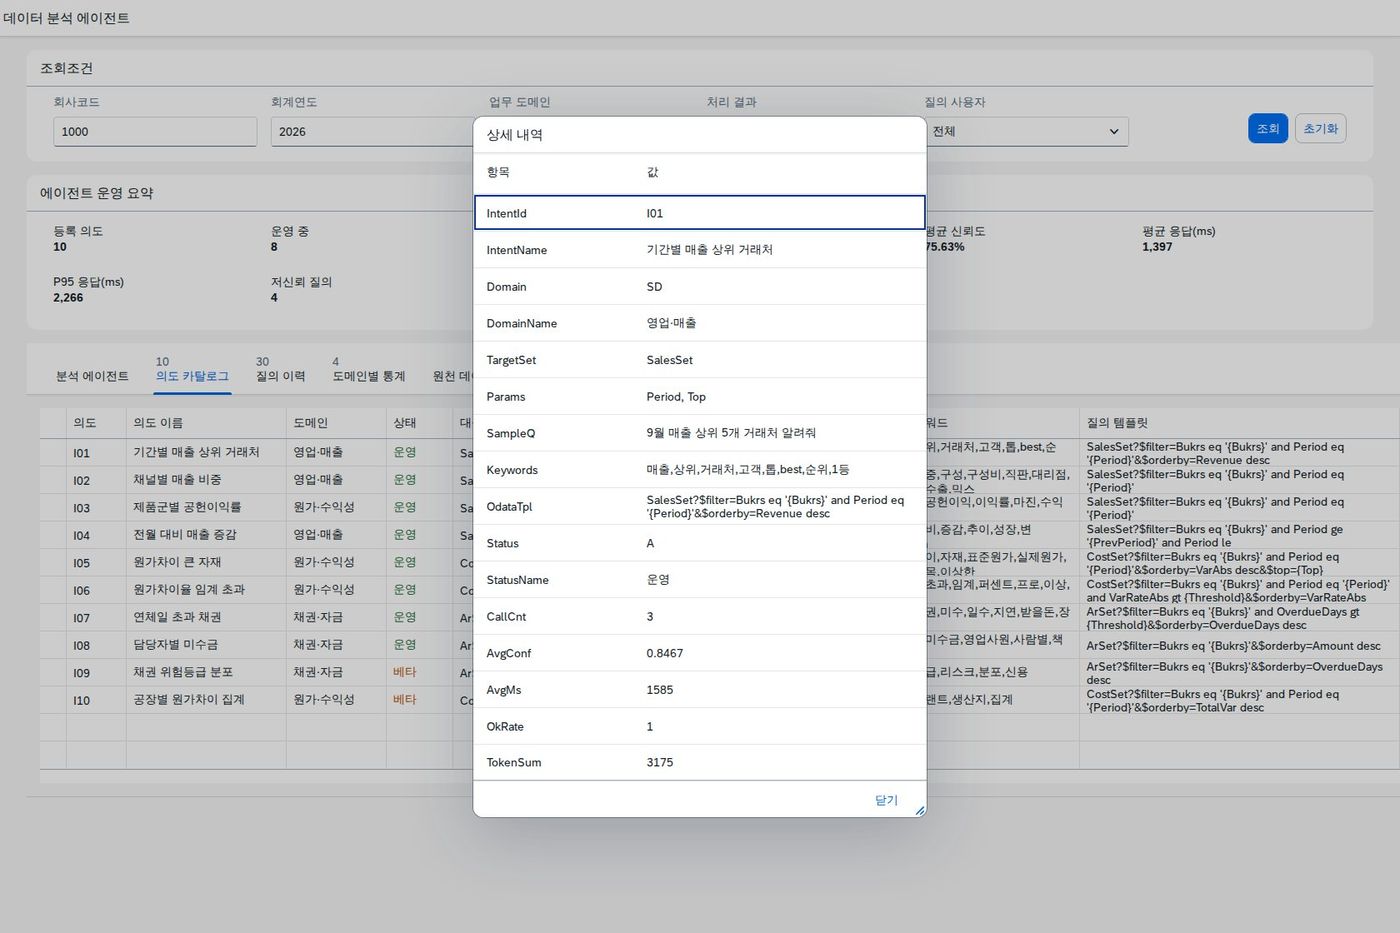
- 해석이 틀렸으면 의도 카탈로그 탭에서 그 의도의 인식 키워드와 질의 템플릿을 확인합니다.
- 질의 이력 탭에서 누가 무엇을 물었고 어떤 질의가 생성됐는지, 토큰을 얼마나 썼는지 봅니다.
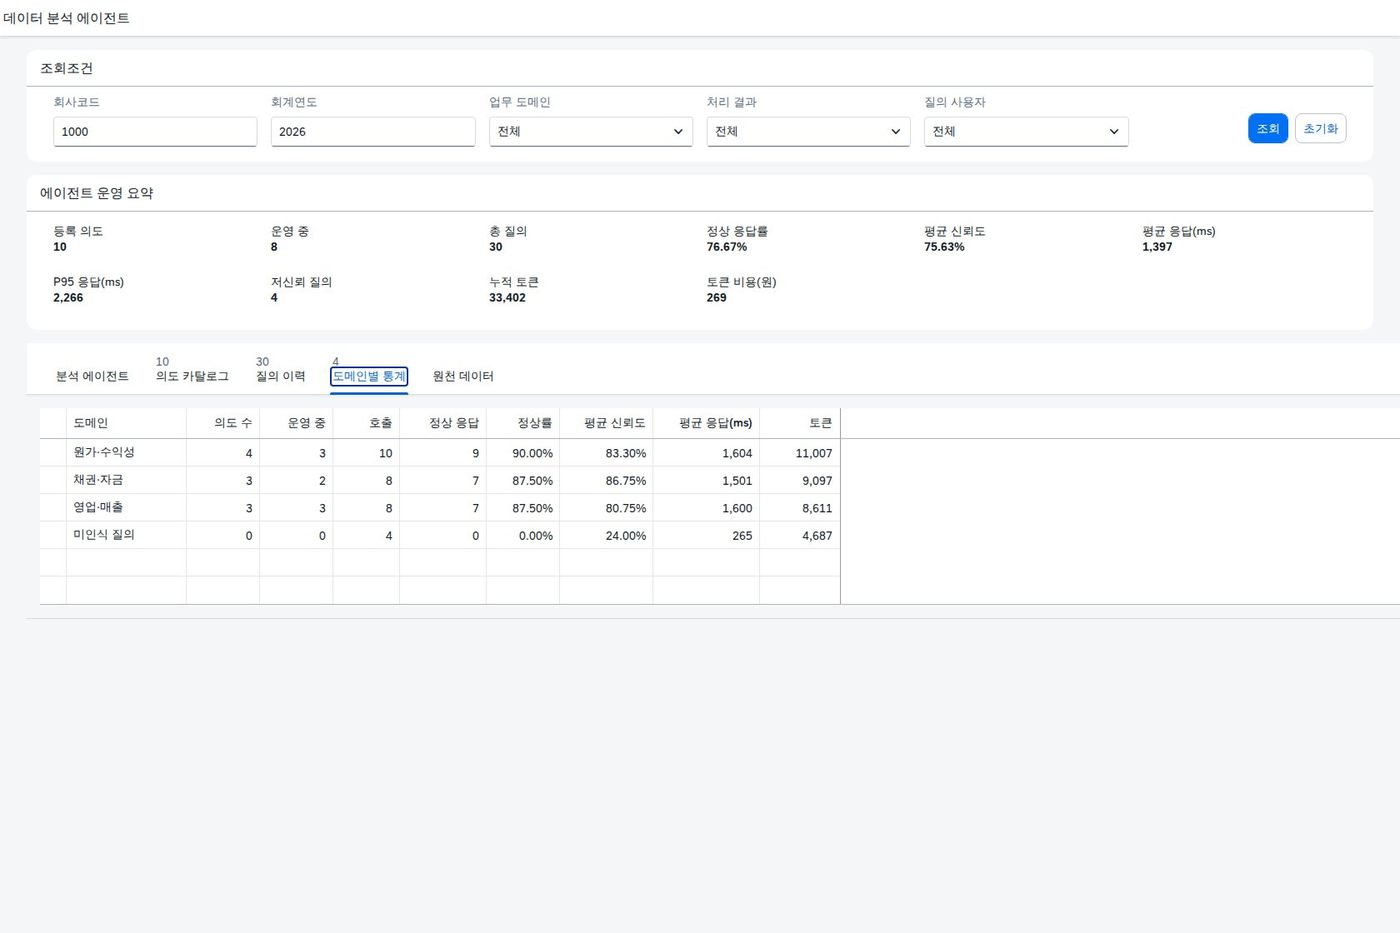
- 도메인별 통계 탭에서 정상률이 낮은 영역과 미인식 질의를 모아 봅니다.
- 분석 결과가 의심스러우면 원천 데이터 탭에서 매출·원가·채권 원천을 그대로 확인합니다.
- CSV 내려받기(UTF-8 BOM)로 현재 탭의 결과를 저장합니다.
자연어가 질의가 되는 여섯 단계
자연어 한 줄이 조회 결과가 되기까지 여섯 단계를 지납니다. LLM 이 맡는 구간은 2·3 단계뿐이고, 나머지는 모두 정해진 규칙입니다.
- 문장 정리 — 공백과 조사를 털어 비교하기 좋은 형태로 바꿉니다.
- 의도 선택 — 등록된 10종의 인식 키워드와 겹치는 정도를 재어 가장 높은 하나를 고릅니다.
적합도 = 겹친 키워드 수 ÷ 전체 키워드 수 × 0.55 + min(겹친 수, 4) × 0.11 + 단서 가중치 + (추천 질문과 완전히 같으면 0.20) - 파라미터 추출 — 문장에서 기간(YYYYMM · N월) · 상위 N · 임계 비율 · 일수를 찾습니다. 숫자 단서는 의도 선택의 가중치로도 들어갑니다 — 비율이 있으면 원가차이율 의도에, 일수가 있으면 연체 의도에 가중치가 붙습니다.
- 신뢰도 판정 —
신뢰도 = min(0.98, 0.40 + 적합도 × 0.72). 임계값 아래면 질의를 만들지 않고 해석 실패로 기록합니다. - 질의 생성·실행 — 의도에 등록된 OData 템플릿에 파라미터를 끼워 넣습니다. 템플릿은 전부 엔티티셋 +
$filter형태이고 조건은and로만 이어집니다. - 집계·코멘트 — 조회 결과를 의도에 맞게 묶어(상위 N · 비중 · 증감 · 분포) 표로 만들고, 그 숫자로 분석 코멘트 문장을 채웁니다. 숫자를 문장이 만들어 내지 않습니다.
등록된 의도 10종입니다. 각 의도는 대상 엔티티셋과 파라미터가 정해져 있습니다.
| 의도 | 이름 | 도메인 | 대상 | 파라미터 | 예시 질문 |
|---|---|---|---|---|---|
| I01 | 기간별 매출 상위 거래처 | 영업·매출 | SalesSet | Period, Top | 9월 매출 상위 5개 거래처 알려줘 |
| I02 | 채널별 매출 비중 | 영업·매출 | SalesSet | Period | 9월 채널별 매출 비중 보여줘 |
| I03 | 제품군별 공헌이익률 | 영업·매출 | SalesSet | Period | 제품군별 공헌이익률 비교해줘 |
| I04 | 전월 대비 매출 증감 | 원가·수익성 | SalesSet | Period | 9월 매출 전월 대비 증감 알려줘 |
| I05 | 원가차이 큰 자재 | 원가·수익성 | CostSet | Period, Top | 원가 차이가 큰 자재 10개 뽑아줘 |
| I06 | 원가차이율 임계 초과 | 원가·수익성 | CostSet | Period, Pct | 원가차이율 10% 넘는 자재 찾아줘 |
| I07 | 연체일 초과 채권 | 채권·자금 | ArSet | Days | 90일 넘게 연체된 채권 보여줘 |
| I08 | 담당자별 미수금 | 채권·자금 | ArSet | — | 담당자별 미수금 집계해줘 |
| I09 | 채권 위험등급 분포 | 채권·자금 | ArSet | — | 채권 위험등급 분포 알려줘 |
| I10 | 공장별 원가차이 집계 | 원가·수익성 | CostSet | Period | 공장별 원가차이 합계 보여줘 |
처리 결과는 세 가지로 갈립니다.
| 결과 | 조건 | 질의 생성 | 기록 |
|---|---|---|---|
| 정상 응답 | 의도를 고르고 조회 결과가 있다 | 생성·실행 | 결과 행수와 토큰을 남깁니다 |
| 결과 없음 | 의도는 골랐으나 조건에 맞는 행이 없다 | 생성·실행 | 행수 0 으로 남깁니다 — 숫자를 꾸며 내지 않습니다 |
| 해석 실패 | 신뢰도가 임계값 아래다 | 만들지 않음 | 미인식 질의로 모아 의도 추가 후보로 둡니다 |
질의 한 건이 남기는 것
질의 한 건이 거치는 호출과 기록입니다.
| 단계 | 서비스 호출 | 남는 기록 |
|---|---|---|
| 조회 | IntentSet · ChatLogSet · DomainStatSet · AgentCheckSet | — |
| 질문 입력 | 없음 (해석은 화면에서) | — |
| 질의 실행 | 의도에 등록된 엔티티셋 + $filter | 생성된 주소 · 결과 행수 · 응답 시간 · 입력·출력 토큰 |
| 집계·코멘트 | 없음 | — |
| 원천 확인 | SalesSet · CostSet · ArSet | — |
임계값 비교에서 음수를 다루는 방식만 조금 다릅니다. 원가차이율은 음수가 될 수 있어 or 로 양쪽을 걸어야 할 것 같지만, 절댓값 필드를 따로 두어 비교 하나로 풀었습니다.
CostSet?$filter=Bukrs eq '1000' and Period eq '202609' and VarRateAbs gt 0.1
       &$orderby=VarRateAbs desc

ArSet?$filter=Bukrs eq '1000' and OverdueDays gt 120&$orderby=OverdueDays desc

SalesSet?$filter=Bukrs eq '1000' and Period ge '202608' and Period le '202609'
        &$orderby=Period,Revenue desc
조회조건
| 조회조건 | 필수 | 설명 |
|---|---|---|
| 회사코드 | 필수 | 1000 — Bukrs eq |
| 회계연도 | 필수 | 2026 — Gjahr eq |
| 업무 도메인 | 선택 | 영업·매출 · 원가·수익성 · 채권·자금, 전체이면 조건 없음 |
| 처리 결과 | 선택 | 정상 응답 · 결과 없음 · 해석 실패 |
| 질의 사용자 | 선택 | 7명 중 선택 |
| 질문 문장 | 선택 | 분석 에이전트 탭 — 추천 질문 또는 직접 입력, Enter 키로 실행 |
결과 컬럼
| 영역 | 내용 |
|---|---|
| 요약 지표 | 등록 의도 · 운영 의도 · 총 질의 · 정상 응답 · 결과 없음 · 해석 실패 · 정상 응답률 · 평균 신뢰도 · 평균 응답시간 · P95 응답시간 · 저신뢰 건수 · 누적 토큰 · 토큰 비용 |
| 분석 에이전트 | 질문 원문 · 인식 의도와 신뢰도 · 추출 파라미터 · 생성된 OData 주소 · 조회 행수 · 집계 표 · 분석 코멘트 |
| 의도 카탈로그 | 의도 ID · 이름 · 도메인 · 대상 엔티티셋 · 파라미터 · 예시 질문 · 인식 키워드 · OData 템플릿 · 운영 상태 · 호출 수 · 평균 신뢰도 · 평균 응답시간 · 정상률 · 토큰 |
| 질의 이력 | 시각 · 사용자 · 질문 · 인식 의도 · 신뢰도 · 도메인 · 생성된 주소 · 결과 행수 · 응답 시간 · 입력·출력 토큰 · 처리 결과 · 사용자 평가 |
| 도메인별 통계 | 도메인 · 의도 수 · 운영 수 · 호출 수 · 정상 수 · 정상률 · 평균 신뢰도 · 평균 응답시간 · 토큰 합계 |
| 원천 데이터 | 매출 실적(기간·거래처·채널·제품군·매출액·매출원가·공헌이익·공헌이익률) · 원가 차이(자재·공장·표준·실제·차이·차이율) · 채권 연체(거래처·담당자·금액·연체일·연령구간·위험등급) |
SAP 표준 기능 매핑
| T-code | 이름 | 쓰임 |
|---|---|---|
VA05 | 판매오더 목록 | 매출 실적의 원천 |
S_ALR_87013611 | 코스트센터 실적/계획 비교 | 원가 차이 분석의 원형 |
KKBC_HOE | 제조오더 원가 분석 | 자재별 표준 대 실제 원가 |
FBL5N | 고객 개별항목 조회 | 채권 연체일과 미수금 |
F.35 | 채권 연령 분석 | 연령구간·위험등급 판정의 원형 |
S/4HANA 에서는 이런 분석을 Fiori 의 분석 앱과 CDS 뷰로 제공하고, Joule 같은 자연어 보조 기능이 그 위에 얹힙니다. 제공 범위와 앱 ID 는 환경·버전별로 달라 확인 필요로 남겼습니다. 이 사례는 그 구조를 OpenUI5 로 작게 재현해 의도 카탈로그를 눈에 보이게 만든 것입니다.
참고 CDS 뷰
@AbapCatalog.viewEnhancementCategory: [#NONE]
@EndUserText.label: '분석 에이전트 질의 이력 (스케치)'
define view entity C_AgentQueryLog
  as select from zagent_log as Log
  association [0..1] to C_AgentIntent as _Intent
    on _Intent.IntentId = Log.intent_id
{
  key Log.log_id                       as LogId,
      Log.company_code                 as Bukrs,
      Log.fiscal_year                  as Gjahr,
      Log.created_at                   as Ts,
      Log.user_id                      as UserId,
      Log.question                     as Question,
      Log.intent_id                    as IntentId,
      _Intent.IntentName               as IntentName,
      _Intent.Domain                   as Domain,
      Log.confidence                   as Confidence,
      Log.odata_url                    as OdataUrl,
      Log.row_count                    as RowCnt,
      Log.elapsed_ms                   as ElapsedMs,
      Log.token_in                     as TokenIn,
      Log.token_out                    as TokenOut,
      Log.token_in + Log.token_out     as TokenSum,
      // 신뢰도 임계값 아래면 질의를 만들지 않는다
      case when Log.odata_url is initial then 'E'          // 해석 실패
           when Log.row_count = 0        then 'N'          // 결과 없음
           else 'S' end                 as Result
}
원천은 에이전트 질의 이력 테이블과 의도 카탈로그이고, 분석 대상 데이터는 판매오더(VBAK · VBAP), 제조오더 원가(AUFK · COSS · COSP), 고객 미결항목(BSID)입니다. 뷰 이름과 필드는 스케치이며, 토큰 사용량을 어디에 남길지는 붙이는 LLM 서비스에 따라 달라 확인 필요로 남겼습니다.
OpenUI5 구성
| 구성 | 내용 |
|---|---|
| 업무 영역 | 관리회계(CO)·영업(SD)·재무회계(FI) — 자연어 분석 질의 |
| 화면 구성 | 조회조건 영역(우측 조회) + 운영 요약 지표 + 분석 에이전트·의도 카탈로그·질의 이력·도메인별 통계·원천 데이터 5개 탭, 상세 Dialog |
| 표 | 행이 많은 표는 sap.ui.table.Table, 짧은 표는 sap.m.Table |
| 막대 표시 | sap.m.ProgressIndicator — 가로 공간을 비율로 늘려 좁아지지 않게 두었습니다 |
| 데이터 모델 | OData V2 모델을 앱 설정(manifest)에서 선언하고, 표마다 해당 엔티티셋에 바인딩 |
| 조회조건 처리 | 필터 객체로 만들어 $filter 로 전달하며 "전체"는 조건을 만들지 않음 |
| 질의 생성 | 의도 카탈로그의 템플릿 문자열에 파라미터를 끼워 넣어 엔티티셋 조회로 실행 |
| 해석 | 키워드 겹침 + 숫자 단서 가중치 — LLM 호출로 바꿔 끼울 수 있도록 분리 |
| 실패 안내 | 서비스 연결 실패와 요청 실패를 구분해 사용자 메시지로 안내 |
| 테마 | sap_horizon · 한국어 |
파일 구성
| 구분 | 내용 |
|---|---|
| 앱 본체 | index.html · manifest.json · Component.js · controller · view · model · i18n · css |
| 데이터 서비스 | OData 서비스 정의(metadata.xml)와 엔티티셋 7종 데이터 |
| 검증 전용 | 앱 본체와 분리된 검증용 샘플 데이터 구성 |
| 설명서 | readme.html (12개 절) |
검증 결과
검증용 샘플 데이터는 회사코드 1000 · 회계연도 2026 기준으로 매출 실적 249행, 원가 차이 30행, 채권 연체 41행, 질의 이력 30건을 원 단위로 맞물리도록 구성했습니다.
| 대사식 | 검사 | 결과 | 차이 건수 |
|---|---|---|---|
| 매출액 = 매출원가 + 공헌이익 | 249 | 일치 | 0 |
| 공헌이익률 = 공헌이익 ÷ 매출액 | 249 | 일치 | 0 |
| 원가차이 = 실제원가 − 표준원가 | 30 | 일치 | 0 |
| 차이율·절대차이율·절대차이·총차이 산식 일치 | 30 | 일치 | 0 |
| 연체일 → 연령구간·위험등급 판정 | 41 | 일치 | 0 |
| 질의 토큰 합계 = 입력 + 출력 | 30 | 일치 | 0 |
| 해석 실패·결과 없음 건의 질의·행수 정합 | 30 | 일치 | 0 |
해석이 제대로 되는지는 의도 10종의 예시 질문과, 표현을 바꾼 변형 질문을 함께 넣어 확인했습니다. 예시 질문은 모두 해당 의도로 해석됐고, "지난달 매출 톱10 고객 뽑아줘" 처럼 표현이 다른 문장도 같은 의도로 들어갔습니다. 반대로 등록되지 않은 영역의 질문은 해석 실패로 떨어져 미인식 질의에 모였습니다 — 샘플 30건 중 4건입니다.
생성된 질의는 모두 실제로 실행해 결과 행수를 확인했습니다. 임계값 비교에서 음수가 섞여도 조건이 and 하나로 풀리도록 절댓값 필드를 쓴 부분과, 기간 비교가 ge·le 범위로 나가는 부분을 따로 확인했습니다. 정상 응답률 76.67%, 평균 신뢰도 0.7563, 평균 응답 1,397ms, P95 2,266ms 는 질의 이력 30건에서 집계한 값이며 도메인별 합계와도 일치했습니다.
자주 묻는 질문
LLM 이 SQL 을 직접 짜는 방식과 무엇이 다릅니까?
이 화면은 LLM 에게 질의문을 짜게 하지 않습니다. 쓸 수 있는 질의를 의도 카탈로그에 10종으로 미리 등록해 두고, 자연어 문장을 그 10종 중 하나로 고르는 일만 맡깁니다. 고른 뒤에는 등록된 OData 템플릿에 파라미터만 끼워 넣어 호출합니다. 질의가 미리 정해져 있으니 권한 밖의 테이블을 읽거나 의도하지 않은 조건이 섞일 여지가 없고, 응답이 틀렸을 때 어느 의도가 잘못 골렸는지 추적할 수 있습니다.
의도를 못 고르면 어떻게 됩니까?
신뢰도가 임계값 아래면 해석 실패로 처리하고 질의를 만들지 않습니다. 샘플에서는 30건 중 4건이 그렇게 처리되어 정상 응답률 76.67% 로 집계됐습니다. 이 건들은 도메인별 통계에서 미인식 질의로 한 줄에 모이고, 거기서 어떤 의도를 추가해야 하는지 후보를 찾습니다. 빈 결과를 그럴듯하게 꾸며 내는 것보다 못 알아들었다고 말하는 편이 안전합니다.
분석 코멘트의 숫자는 LLM 이 만든 것입니까?
아닙니다. 코멘트에 들어가는 숫자는 모두 조회 결과에서 계산한 값입니다. 상위 거래처의 비중, 증감률, 분포 구간별 금액은 화면이 계산해 문장에 끼워 넣습니다. LLM 의 몫은 의도를 고르고 파라미터를 뽑는 데까지입니다 — 숫자를 쓰게 하지 않습니다.
자유 질의는 어떻게 파라미터를 뽑습니까?
문장에서 기간·상위 N·임계값·일수를 찾습니다. "연체 120일 넘는 채권 보여줘" 라면 120을 뽑아 OverdueDays gt 120 으로 바꿉니다. "원가차이율 10% 넘는" 이라면 비율을 뽑아 임계값 조건으로 만듭니다. 숫자 단서가 의도 선택에도 가중치로 들어가 비슷한 의도끼리 헷갈리는 일을 줄입니다.
토큰 비용은 왜 함께 보여줍니까?
에이전트를 붙이면 질의 한 건마다 비용이 발생하고, 쓰는 사람은 그 사실을 보지 못합니다. 질의 이력에 입력·출력 토큰을 남기고 도메인별로 합산해 두면 어느 업무 영역에서 비용이 나가는지, 정상률이 낮은데 토큰만 쓰는 영역이 어디인지 보입니다. 샘플에서는 누적 33,402 토큰 · 269원입니다.
조회 데이터를 함수가 아니라 엔티티셋으로 읽는 이유가 있습니까?
조회는 엔티티셋 + $filter 가 표준에 맞고, 뒤에 실제 OData 서비스가 붙을 때 주소만 바꾸면 그대로 동작합니다. 함수 임포트는 저장·승인·전기 같은 기능 호출에만 남겼습니다. 의도 카탈로그의 질의 템플릿도 모두 엔티티셋 형태입니다.
조회조건에 or 를 쓰지 않은 이유가 있습니까?
OData 구현마다 and 와 or 가 섞인 조건의 해석이 갈립니다. 그래서 기간 비교는 ge·le 범위로, 음수를 다루는 임계값 비교는 절댓값 필드를 따로 두어 gt 하나로 풀었습니다. 조건이 전부 and 이면 어느 구현에서나 같게 해석됩니다.
실제 업무에 붙이려면 무엇이 더 필요합니까?
의도 카탈로그에 등록할 질의를 업무에서 실제로 묻는 문장에서 뽑아야 하고, 사용자 권한이 질의 단계에서 걸리도록 해야 합니다. 그리고 의도를 고르는 부분을 실제 LLM 호출로 바꾸게 됩니다. 이 사례의 해석은 키워드 가중치 방식이며, 카탈로그·이력·비용 집계 구조는 그대로 쓸 수 있도록 분리해 두었습니다.
분석 에이전트를 붙이기 전에, 쓸 수 있는 질의부터 정리해 두세요
자연어를 그대로 질의문으로 번역하게 맡기면 권한과 조건을 통제하기 어렵습니다. 업무에서 실제로 묻는 문장을 모아 의도 카탈로그로 정리해 두면, 그 뒤에 어떤 모델을 붙이든 답의 근거와 비용을 추적할 수 있습니다. 현재 SAP 환경에서 어떻게 적용되는지 함께 확인해 드립니다.