수입 품질 클레임 회수 다차원 분석 — 공급사·자재·플랜트로 돌려 보고 예정 대비 차이를 여섯 요인으로 가르는 수입 품질 리포트
큐브 집계 · 끌어다 놓는 축 · 칸에서 클레임 라인까지의 드릴스루 · 예정 대비 차이와 여섯 요인분해 · 행에 남는 변동 사유 · 숫자를 모델에 맡기지 않는 AI 분석 · 스스로 도는 AI 에이전트 — 소개 영상과 실제 화면, 그리고 CDS 코드까지
소개 영상블로그 목차 순서대로 · 자막 포함
도입 포인트 — 이 앱을 사용해야 하는 이유
수입 담당자가 분기 말에 자주 받는 질문은 "이번 분기 품질 클레임으로 얼마를 잃었고, 공급사에서 얼마를 돌려받았나" 입니다. 클레임 접수는 검수 기록에, 청구는 공급사와 주고받은 서류에, 처리비용은 물류·품질 부서 자료에, 회수는 대금 정산에 흩어져 있습니다. 지금은 이 자료를 엑셀에 모아 공급사별 · 자재별로 다시 합산하고 합계가 맞는지 확인하는 데 시간을 씁니다. 정작 중요한 "예정보다 얼마나 더 났고 왜 그런가" 는 그 뒤에야 이야기됩니다.
이 화면은 그 자리를 바꿉니다. 클레임 라인에서 청구액 · 처리비용 · 회수액 · 순손실을 계산해 한 큐브로 묶고, 공급사 · 원산지 · 자재 · 플랜트 · 청구 통화 · 클레임 유형 · 처리 방식 같은 축을 끌어다 놓으며 봅니다. 칸 하나를 누르면 그 금액을 만든 클레임 라인이 열리고, 비교를 바꾸면 같은 표가 예정 대비 차이 표가 되어 차이를 물량 · 외화 단가 · 환율 · 처리비 · 회수율 · 미계획 여섯 요인으로 가릅니다.
핵심 포인트 여덟 가지
| 핵심 포인트 | 고객이 얻는 것 | 지금 방식이라면 |
|---|---|---|
| ① 축을 바꿔도 합계가 갈라지지 않는 피벗 | 공급사 · 자재 · 플랜트 등 11개 차원을 끌어다 놓아 행 3단계 · 열 2단계로 봅니다. 서버를 다시 부르지 않고 한 큐브에서 다시 묶습니다. | 공급사별 · 자재별 자료를 따로 엑셀 피벗으로 만들고 합계를 다시 맞춥니다. |
| ② 칸에서 클레임 라인까지 | 숫자를 누르면 그 금액을 만든 클레임 라인이 열리고 칸의 값과 라인 합이 같은지 보입니다. | 의심할 때마다 다른 화면에서 조건을 다시 넣고 옮겨 적습니다. |
| ③ 예정 대비 차이를 같은 표에서 | 비교만 바꾸면 실적 · 예정 · 차이 · 차이율이 붙고 금액과 비율 임계를 모두 넘는 칸만 색이 입혀집니다. | 실적 리포트와 예정 대비 리포트를 따로 만듭니다. |
| ④ 총차이를 여섯 요인으로 | 물량 · 외화 단가 · 환율 · 처리비 · 회수율 · 미계획으로 가르고 합이 총차이와 같은지 매번 검산합니다. | "왜 늘었나" 를 엑셀로 풀고 산식이 사람마다 다릅니다. |
| ⑤ 변동 사유를 행에 남긴다 | 사유가 조회 범위와 행 경로에 묶여 축을 바꿔도 따라옵니다. | 같은 질문을 분기마다 다시 하고 지난 답은 메일함에서 찾습니다. |
| ⑥ 역할별 요약과 AI 분석 | 경영진 · 구매 · 물류 · 자금별로 먼저 볼 지표가 바뀌고, AI 해설은 서비스가 계산한 숫자만 문장으로 옮깁니다. | 역할마다 보고서를 따로 만들고 숫자 출처를 따집니다. |
| ⑦ 스스로 도는 감시 | 규칙마다 임계값과 받을 역할이 있어 걸리면 보고가 대기함에 올라옵니다. 실행은 하루 한 번으로 제한됩니다. | 클레임이 튄 날 아무도 열지 않으면 분기 말에야 압니다. |
| ⑧ 표준 문서와 이어 맞춤 | 입고 · 송장 · 전표의 같은 필드를 이어받고 표준 화면으로 원천을 확인합니다. | 표준 화면과 엑셀 사이에 숫자를 옮겨 적다 어긋납니다. |
사례로 보는 효과
검증용 샘플(가상 회사, 2026.04~2026.09 접수)에서 순손실 실적은 27.18억원으로 예정 21.19억원보다 5.99억원(28.3%) 많았습니다. 여섯 요인으로 가르면 미계획 +2.73억원, 회수율 +2.39억원, 처리비 +7,647만원, 외화 단가 +2,092만원, 물량 −592만원, 환율 −360만원이며 합은 총차이와 1원도 다르지 않습니다. 예정 없이 접수된 클레임이 가장 크고, 그다음이 공급사에서 돌려받는 비율이 예정에 못 미친 몫이라는 점이 한 화면에서 보입니다. 공급사로 범위를 좁히면 순손실이 가장 큰 곳(5.63억원)의 요인 구성이 전체와 다르게 나뉘는 것도 같은 방식으로 확인합니다. 모든 이름과 금액은 가정값입니다.
도입하면 달라지는 것
| 구분 | 이전 | 이후 |
|---|---|---|
| 자료 취합 | 접수 기록 · 서류 · 정산 자료를 엑셀에 모음 | 큐브 한 번 읽고 브라우저에서 다시 묶음 |
| 숫자 확인 | 합계를 사람이 대조 | 칸마다 라인 합과 일치 여부 표시, 검산 줄 상시 표시 |
| 차이 설명 | 회의 전날 엑셀로 요인 추정 | 여섯 요인과 변동 사유가 표에 붙어 있음 |
| 감시 | 사람이 열어야 발견 | 규칙에 걸리면 대기함에 보고 |
이런 회사에 맞습니다
수입 자재의 품질 클레임이 공급사 · 자재 · 플랜트 여러 축으로 흩어져 분기마다 엑셀로 다시 묶는 회사, 예정(목표)과 실적의 차이를 "왜" 까지 설명해야 하는 구매 · 품질 · 자금 부서에 맞습니다. 반대로 법정 · 감사 제출 숫자를 직접 만들어 내려는 목적에는 맞지 않으며, 이 화면은 점검 도구입니다.
실행 화면
아래 화면은 검증용 샘플 데이터로 실제 브라우저에서 찍은 것입니다.
사용 방법
조회조건을 정해 조회하면 큐브와 예정 값을 한 번 읽고, 이후 축 전환은 브라우저에서 처리합니다. 칸을 누르면 클레임 라인이 열립니다. 비교를 예정 대비로 바꾸면 차이가 보이고, 차이가 큰 행에는 사유를 남길 수 있습니다. 상단에서 AI 분석 · AI 에이전트 · 레이아웃을 엽니다.
무엇으로 만들었나
OpenUI5 의 표준 컨트롤과 직접 그린 SVG 차트로 만들었고, 서비스는 OData V2 입니다. 외부 라이브러리나 외부 전송은 없으며 AI 모델 연결은 기본 꺼짐입니다.
앱 정보
| 항목 | 내용 |
|---|---|
| 서비스 | impclaim_srv (OData V2, 엔티티셋 16 · 펑션 3) |
| 큐브 규모 | 클레임 라인 3,753건 → 차원 조합 3,406칸 (측정값 6종) |
| 차원 | 접수월 · 분기 · 공급사 · 원산지 · 자재그룹 · 자재 · 플랜트 · 청구 통화 · 인코텀즈 · 클레임 유형 · 처리 방식 |
| 데이터 | 가정값의 가상 회사 — 실제 거래와 무관 |
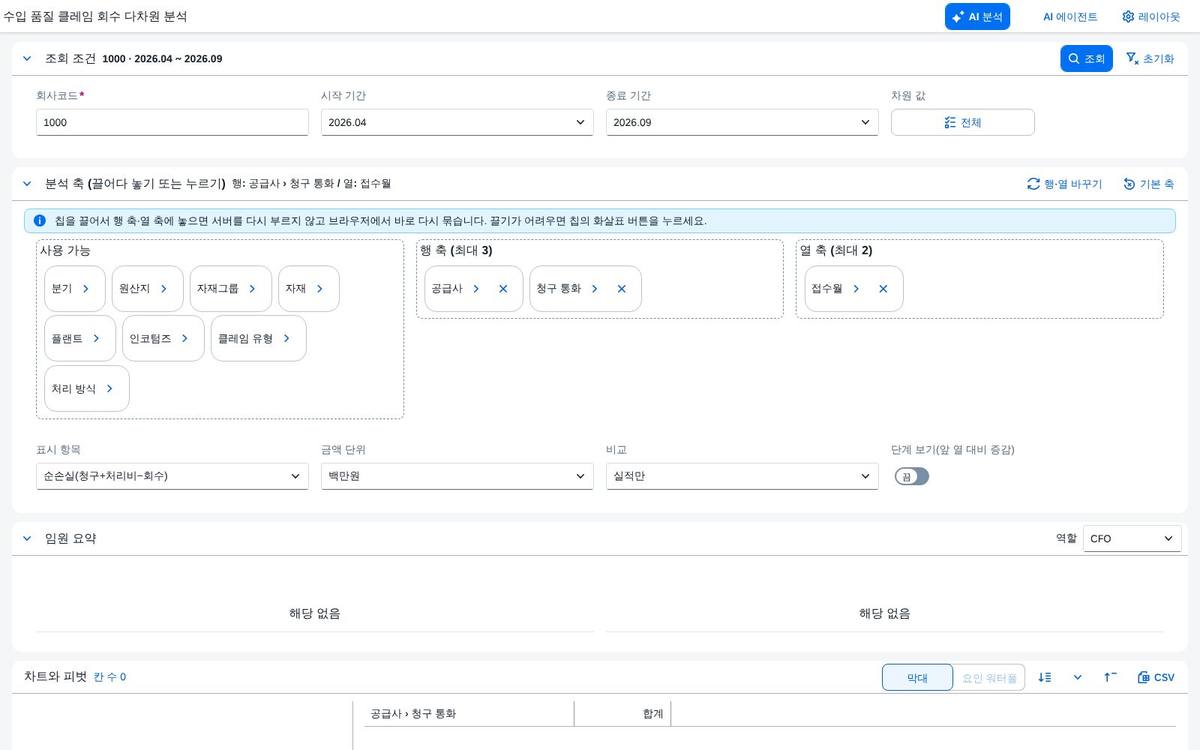
조회조건은 회사코드(필수)와 기간, 선택 사항인 차원 값입니다. 머리 영역은 접을 수 있습니다.
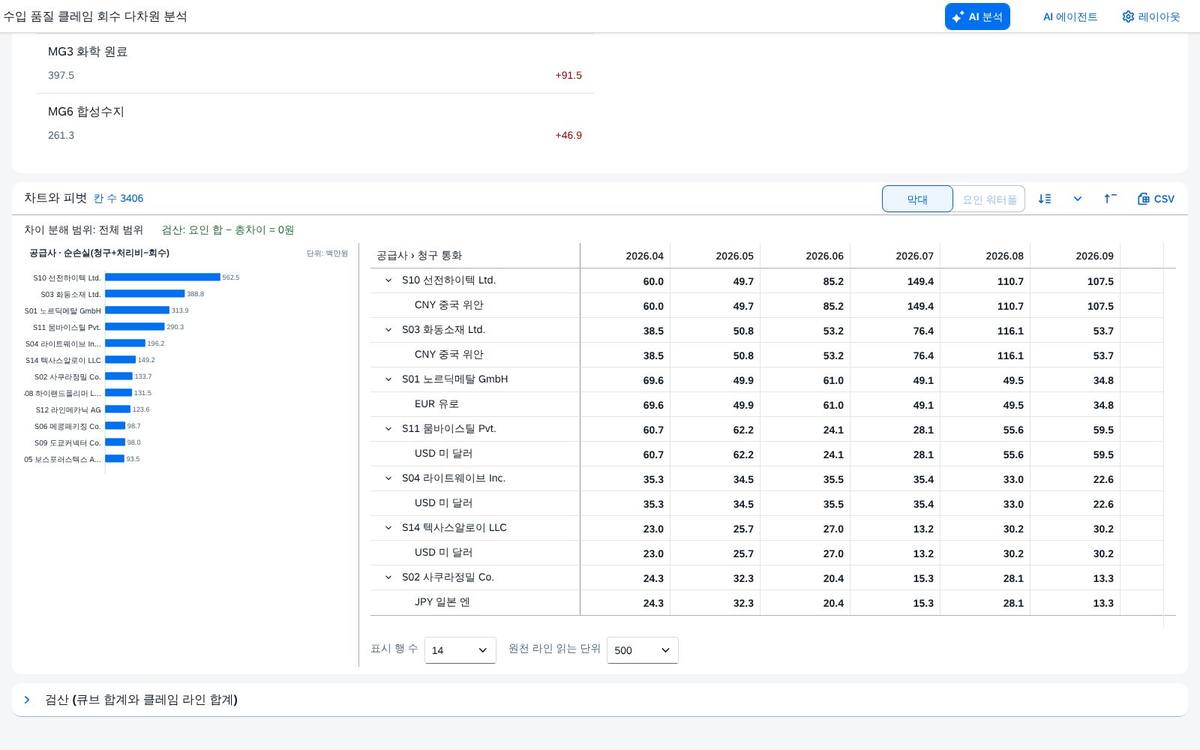
금액은 기본 백만원 단위이고, 표시 항목은 순손실(청구 + 처리비 − 회수)입니다. 칸 수 3,406은 차원 조합 수입니다.
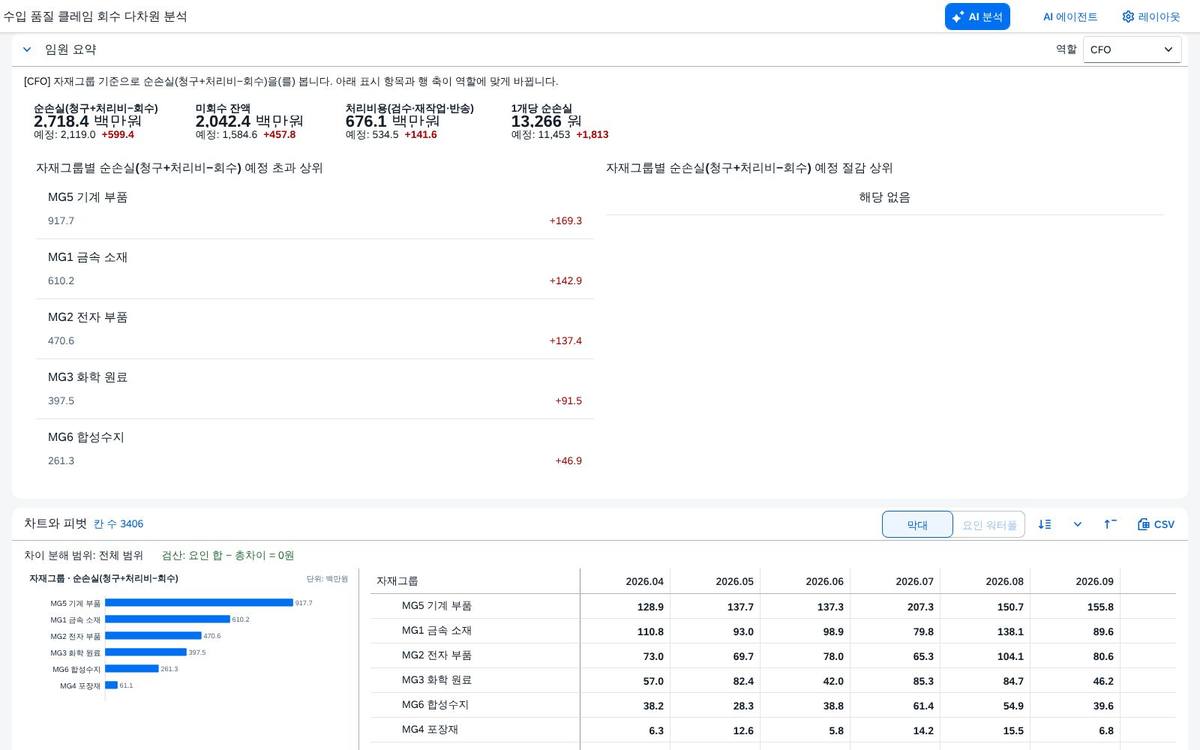
경영진은 순손실과 예정 대비, 구매는 공급사별 클레임률, 물류는 플랜트별 처리비용, 자금은 환율 영향과 미회수 잔액을 먼저 봅니다.
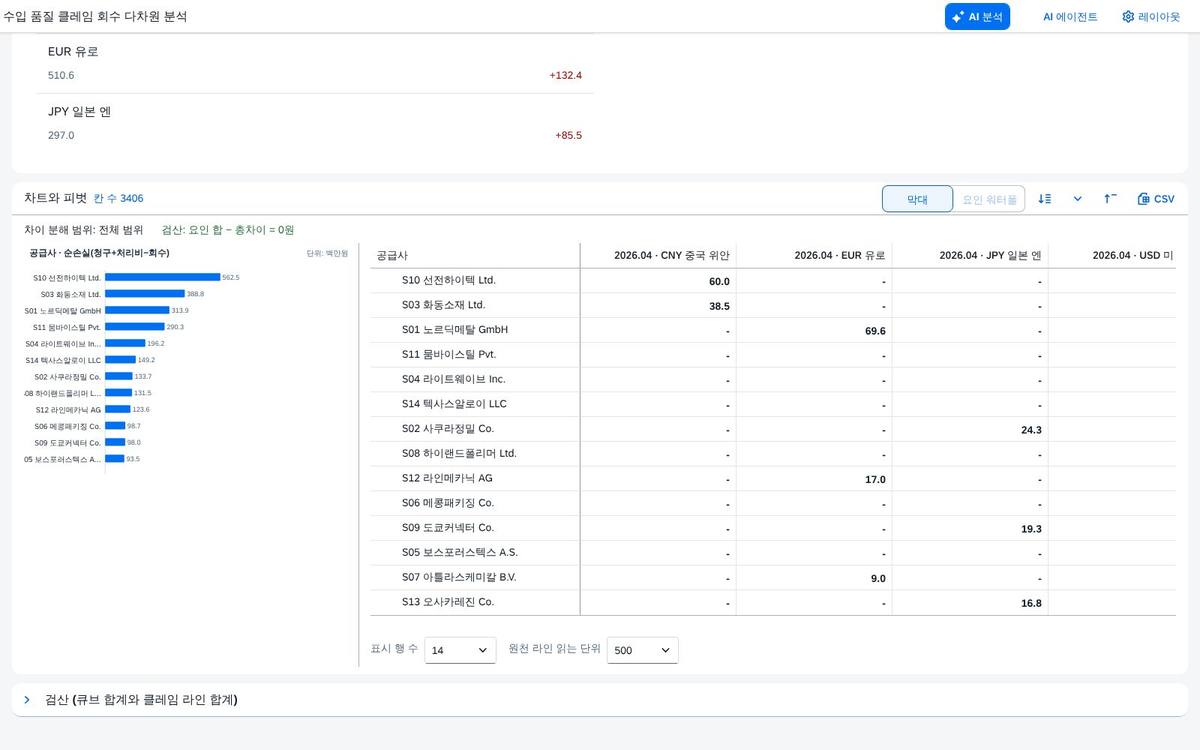
자동 점검에서 축 6가지 배치의 피벗 총합이 모두 큐브 총합과 같았고 재조회 요청은 0건이었습니다.
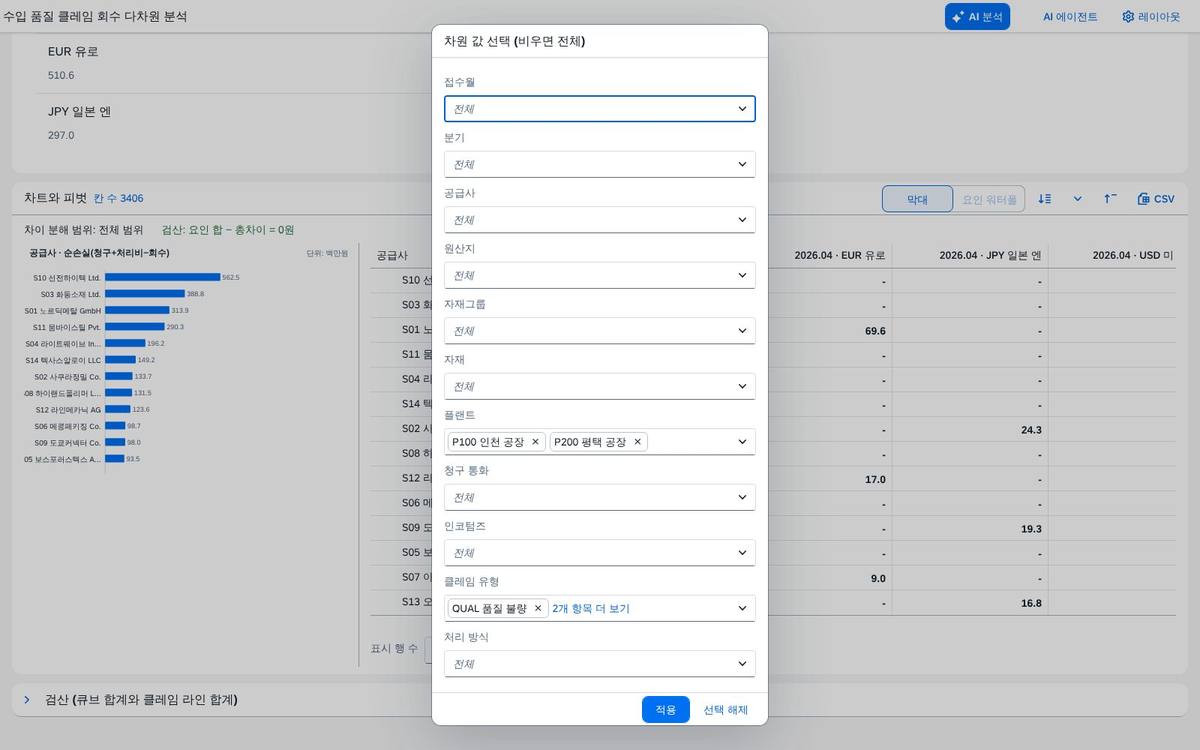
선택한 공급사 값의 합이 큐브에서 같은 값만 골라 더한 합과 같음을 확인했습니다.
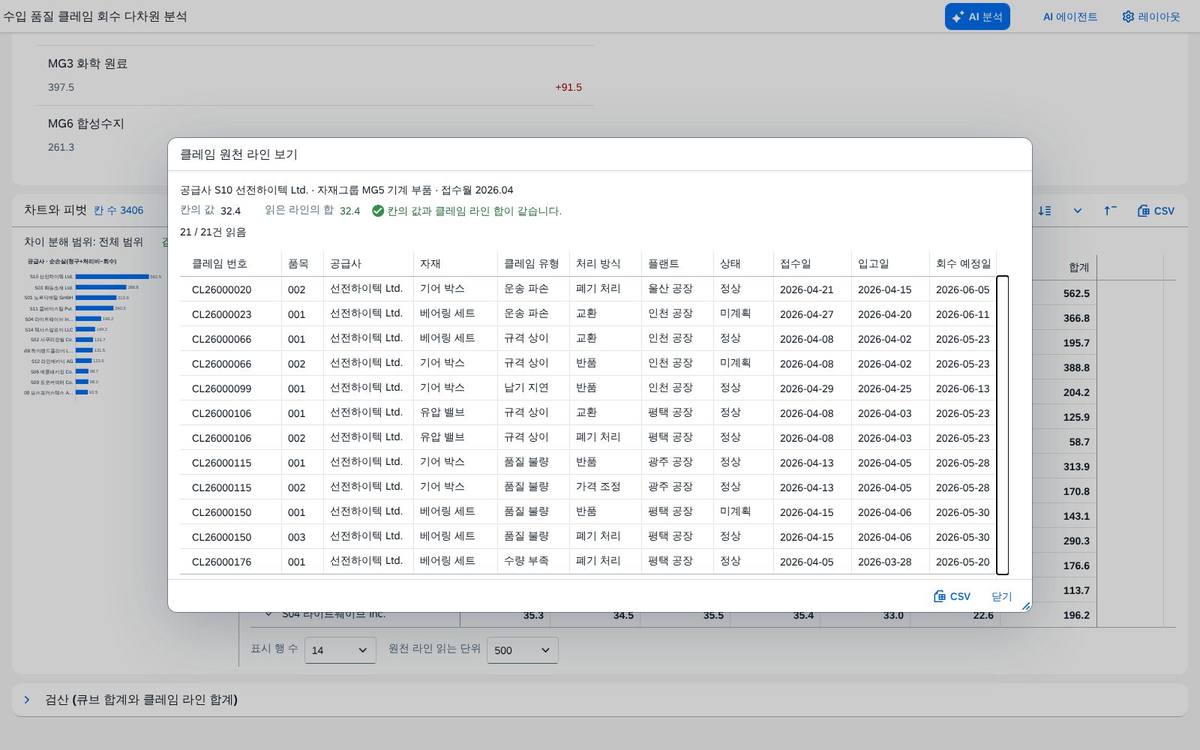
행 경로와 열 조합이 그대로 조회 조건이 됩니다. 12개 칸을 점검해 모두 일치했습니다.
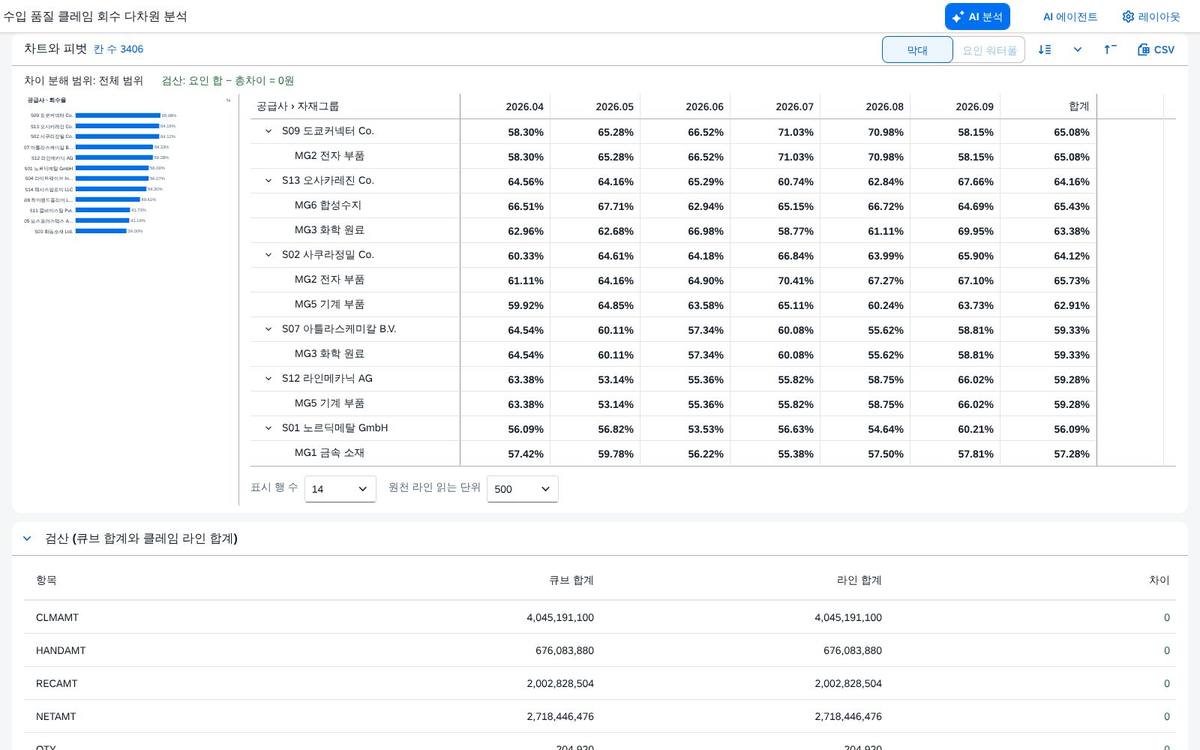
순손실 계산 · 미회수 잔액 · 회수율 · 클레임률 · 클레임 1개당 순손실의 다섯 항목이 있습니다.
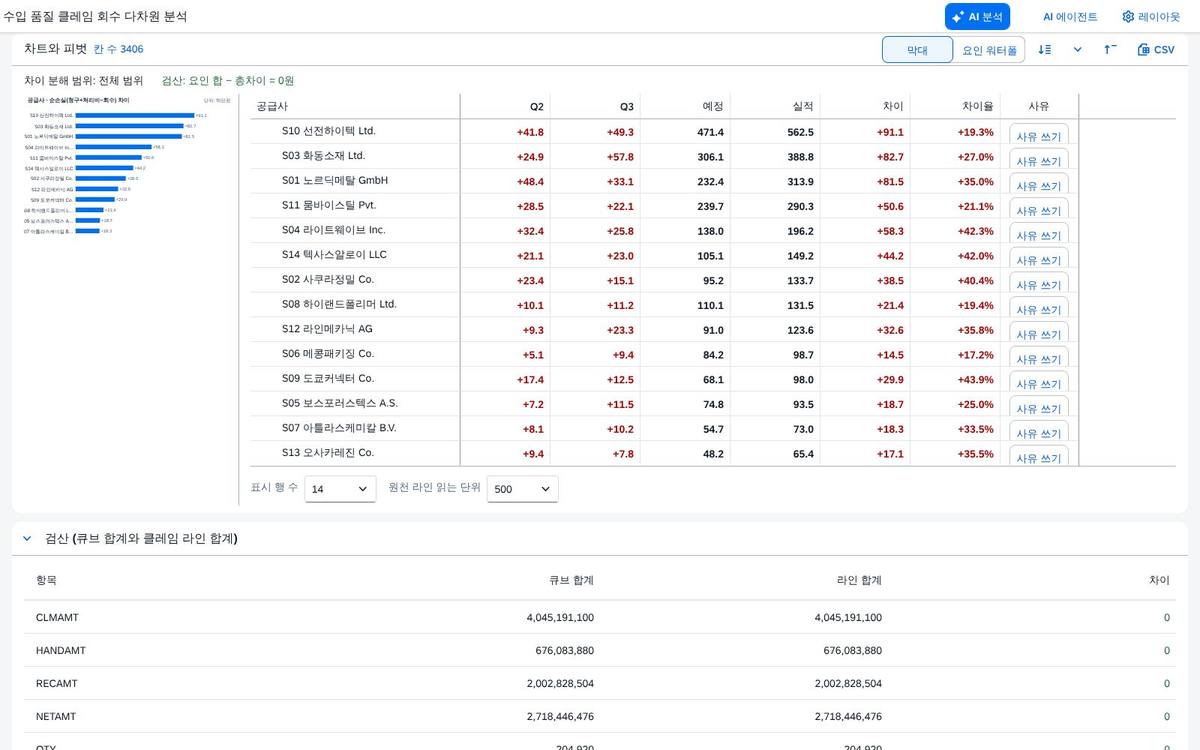
색은 금액과 비율 임계를 둘 다 넘을 때만 입힙니다. 임계는 화면에서 고칩니다.
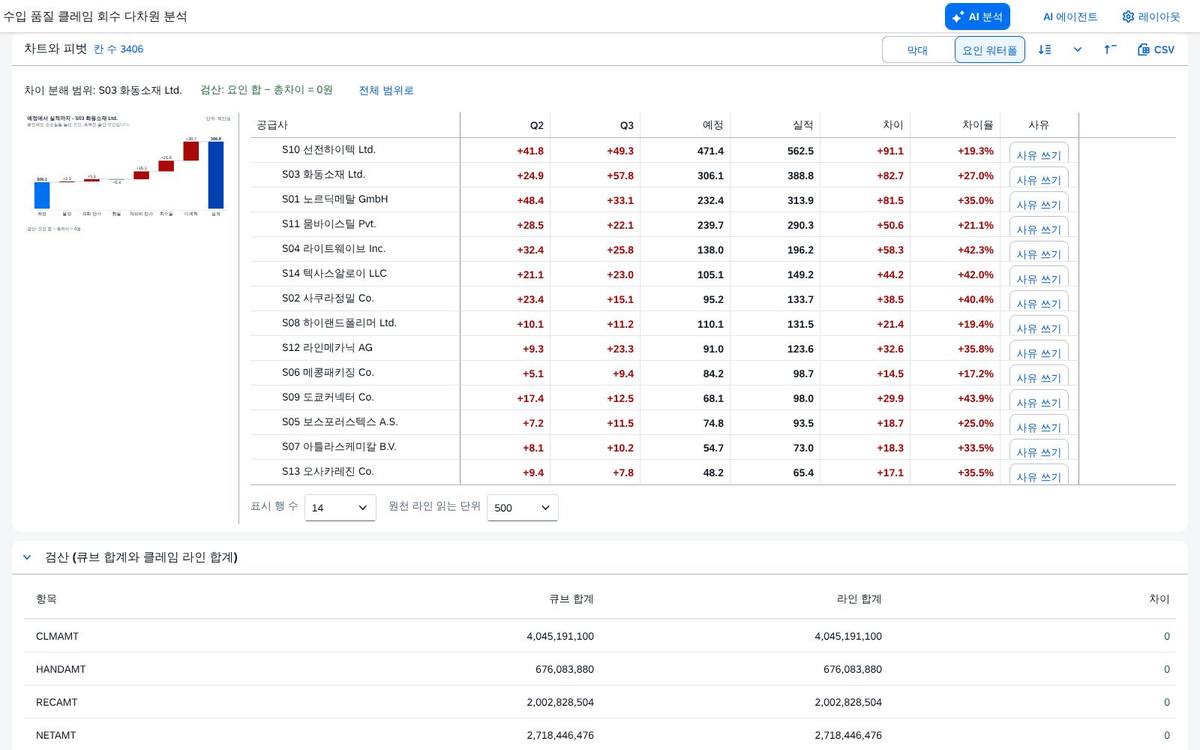
맨 아래 검산 줄이 요인 합 − 총차이 = 0원임을 매번 보여 줍니다.
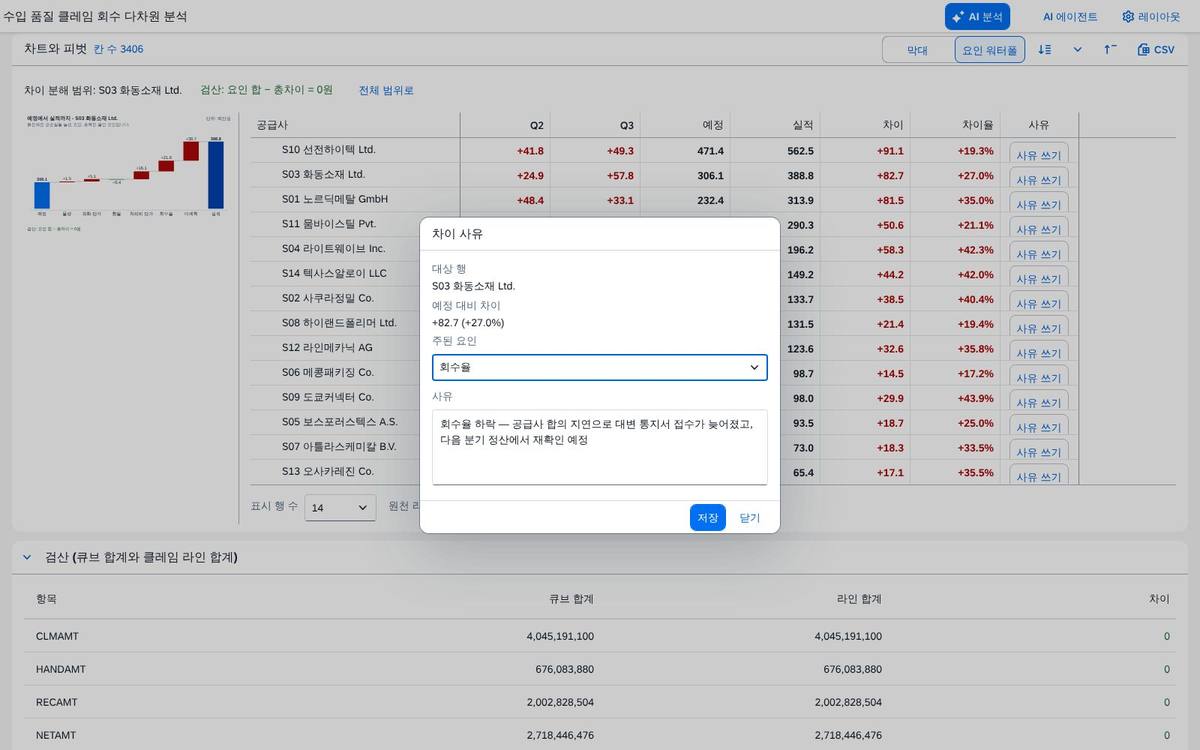
사유의 키는 조회 범위와 행 경로이며 새로 고침 뒤에도 남습니다.
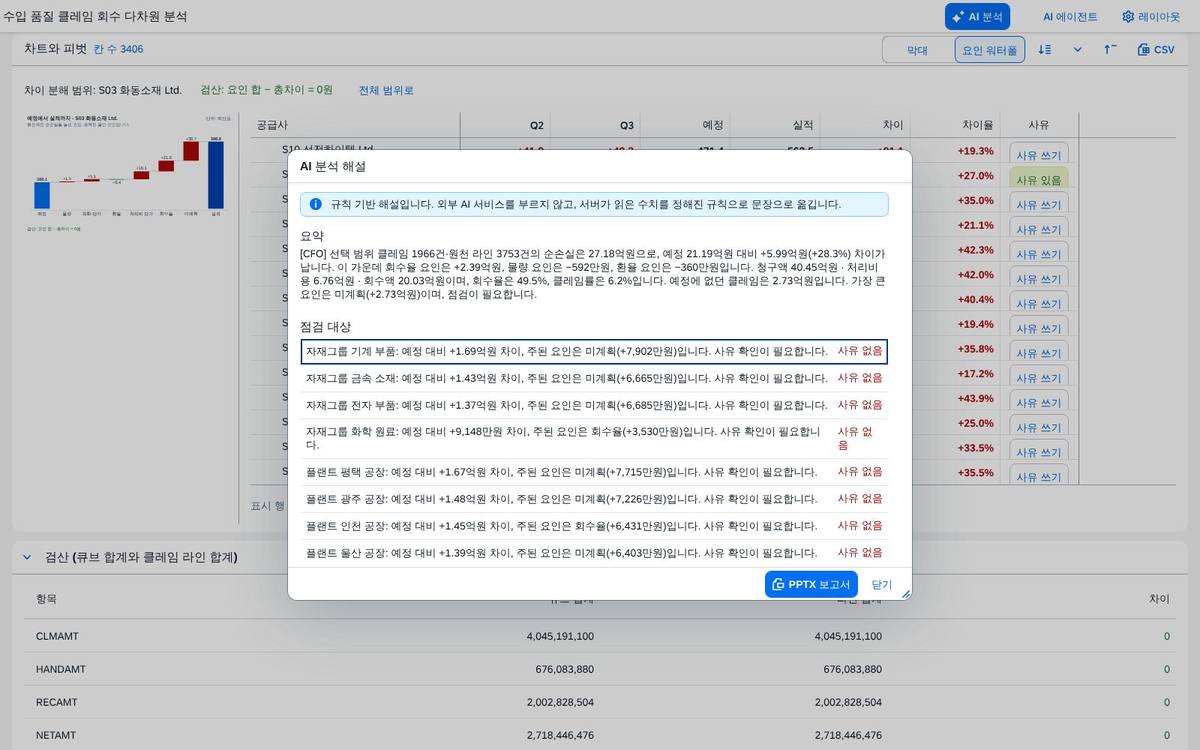
기본은 규칙 기반이며 숫자는 서비스가 계산합니다. 모델 연결은 기본 꺼짐입니다.
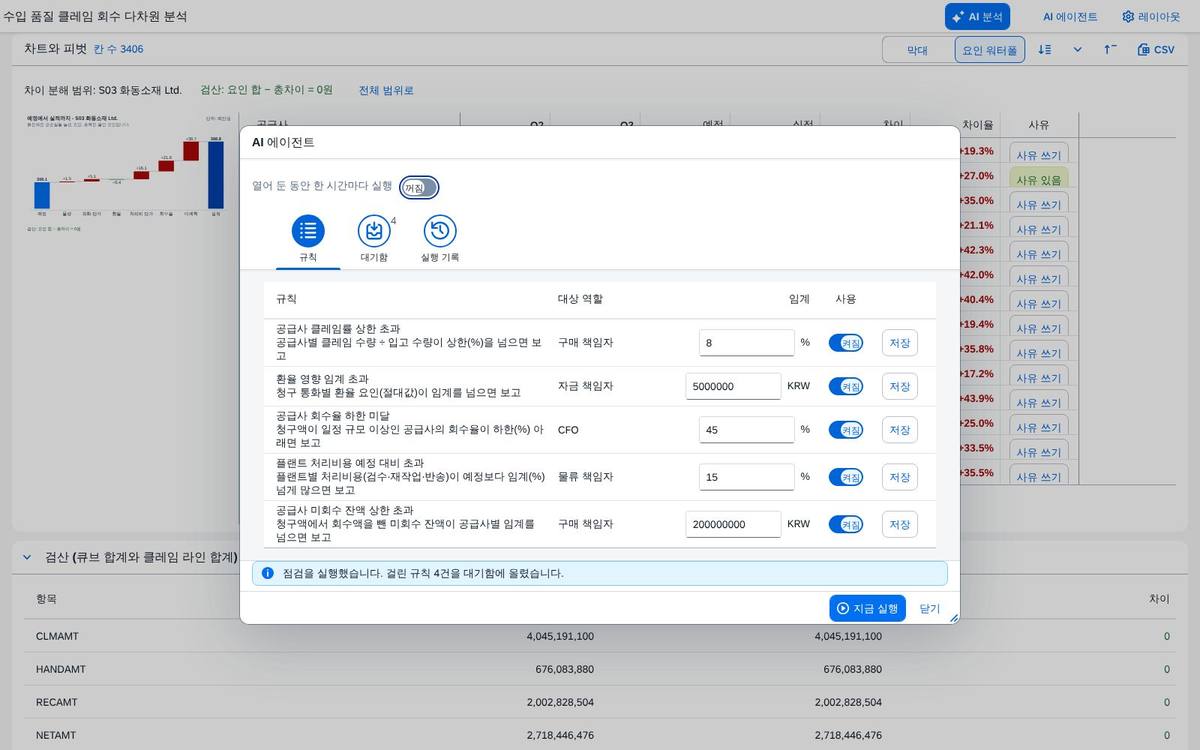
규칙은 클레임률 상한 · 환율 영향 · 회수율 하한 · 처리비 초과 · 미회수 잔액 다섯 가지이며 실행은 하루 한 번입니다.
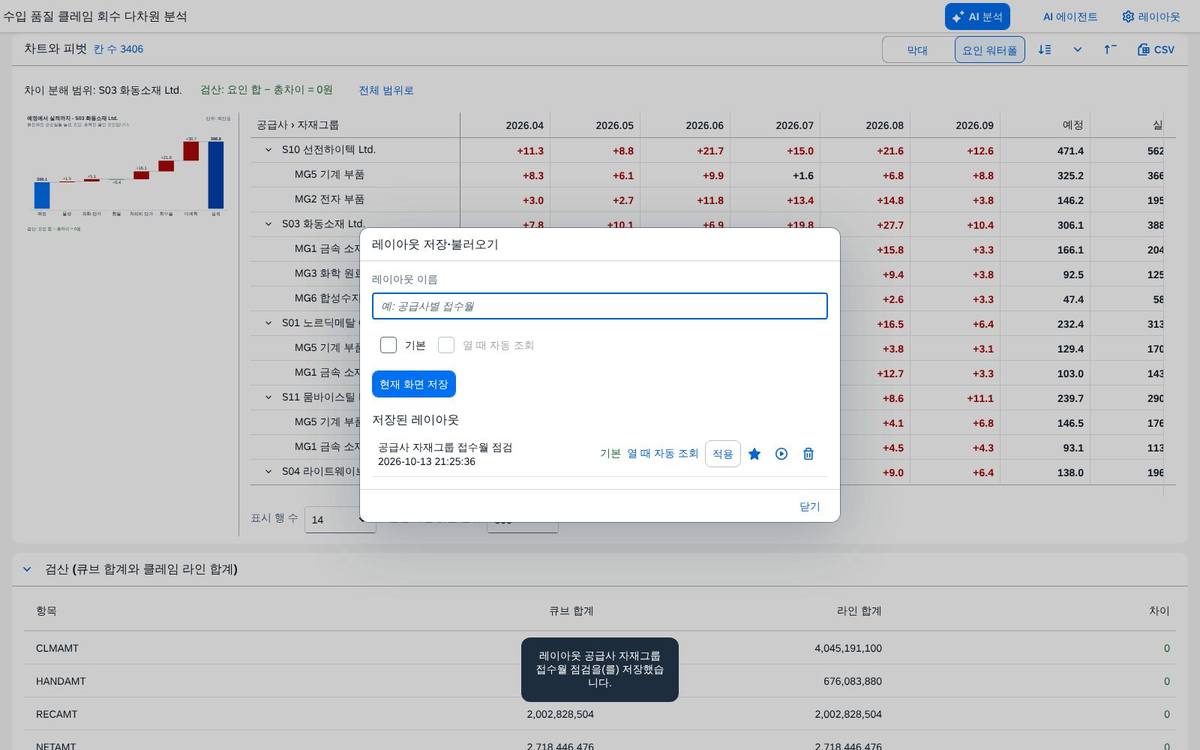
축 · 조회조건 · 표시 항목이 서비스에 저장되어 새로 고침 뒤에도 복원됩니다.
390px 폭에서 가로 스크롤이 생기지 않는지 점검했습니다. 열이 너무 많으면 범위를 좁히라는 안내가 뜹니다.
비용 계산 — 클레임 라인에서 한 칸까지
라인마다 청구액은 클레임 수량 × 외화 단가 × 환율, 처리비용은 수량 × 단위 처리비, 회수액은 청구액 × 회수 비율로 구하고 순손실은 청구액 + 처리비용 − 회수액 입니다. 이 계산은 샘플의 가정값이며 실제 회수 인식 시점과 환율 기준일은 회사 기준으로 확인이 필요합니다.
예정 대비 차이 판정
차이 금액과 차이율이 각각의 임계를 모두 넘는 행만 색이 칠해집니다. 임계가 하나만 넘은 행은 칠하지 않아 작은 모수의 큰 비율이 눈을 끌지 않게 했습니다.
요인분해 — 합이 총차이와 같다
| 요인 | 샘플 결과(전체 범위) | 의미 |
|---|---|---|
| 물량 | −592만원 | 클레임 수량이 예정과 다른 영향 |
| 외화 단가 | +2,092만원 | 외화 단가 차이 |
| 환율 | −360만원 | 청구 통화 환율 차이 |
| 처리비 | +7,647만원 | 단위 처리비 차이 |
| 회수율 | +2.39억원 | 공급사 회수 비율이 예정에 못 미친 영향 |
| 미계획 | +2.73억원 | 예정 없이 접수된 라인 전액 |
| 합계 | +5.99억원 | = 실적 − 예정, 검산 차이 0원 |
조회조건
| 항목 | 설명 |
|---|---|
| 회사코드 · 기간 | 필수 · 접수월 기준 |
| 차원 값 | 다중 선택, 비우면 전체 |
| 표시 항목 · 금액 단위 | 순손실 외 5개 측정값 · 계산항목, 원/천원/백만원 |
| 비교 · 역할 | 실적만/예정 대비 · 경영진/구매/물류/자금 |
결과 컬럼
행 경로 · 열별 값 · 합계 · (예정 대비일 때) 예정 · 실적 · 차이 · 차이율 · 사유입니다. 드릴스루 목록은 클레임 번호 · 공급사 · 자재 · 플랜트 · 수량 · 청구액 · 처리비 · 회수액 · 순손실 등을 보여 줍니다.
좁은 화면에서 달라지는 것
창 폭이 좁으면 표와 차트가 위아래로 쌓이고, 드릴스루는 전체 화면 대화상자로 열립니다. 행 · 열 조합이 상한(열 36개)을 넘으면 앞쪽만 보여 주고 범위를 좁히라고 안내합니다.
파일 구성
Component.js · manifest.json · index.html · readme.html
controller/   Main.controller.js · BaseController.js
view/         Main.view.xml · fragment/ (Agent · Ai · Drill · Layout · Reason)
model/        cube.js · chart.js · layout.js · formatter.js · pptx.js · ErrorHandler.js
odata/        서비스 정의 · 로직 파일 · 샘플 데이터(json)
media/        소개 영상 · 포스터 · 재생 지점
SAP 표준 기능 확장 포인트 — 표준 화면과 어떻게 연계되는지
표준 실행은 SAP 표준 화면이 담당하고, 이 화면은 조회 · 검증 관점을 더해 확장합니다. 기존 표준 화면과 리포트를 없앨 필요가 없습니다. 표준 화면은 계속 문서 단위 확인과 처리에 쓰고, 이 화면은 그 위에서 여러 축으로 묶어 비교하는 일을 맡습니다.
표준으로 되는 것과 안 되는 것
| 구분 | 표준 화면 | 이 화면 |
|---|---|---|
| 문서 한 건 확인 | 입고 · 송장 · 전표 화면에서 가능 | 칸에서 라인으로 내려가 같은 값을 확인 |
| 여러 축 비교 | 리포트마다 축이 고정 | 11개 차원을 끌어다 놓음 |
| 예정 대비 차이 요인 | 표준에는 요인 개념 없음 | 여섯 요인으로 가르고 검산 |
| 변동 사유 기록 | 없음 | 행에 남음 |
| 법정 · 감사 숫자 | 표준 전표 기준 | 만들지 않음 — 점검용 |
표준 화면별 연계 지점
| 업무 | 표준 화면 | 표준이 보여 주는 것 | 이 화면이 더하는 것 |
|---|---|---|---|
| 입고 문서 확인 | MIGO · MB51 | 자재문서 단위 입고 | 입고 수량 대비 클레임률 |
| 송장 검증 | MIRO · MIR4 | 송장 단위 입력 · 표시 | 청구 · 회수를 공급사별로 합산해 맞춤 |
| 공급사 개별 항목 | FBL1N | 공급사 미결 · 결제 항목 | 회수액과 미회수 잔액을 공급사 축으로 비교 |
| 회계 전표 | FB03 | 전표 한 건 | 집계에서 전표로 내려가 원천 확인 |
| 품질 통지 | QM 통지 화면 | 통지 단위 처리 | 접수 건수를 유형 · 처리 방식 축으로 묶음 |
화면 이름은 일반적인 표준 기능을 가리키며 실제 메뉴와 권한은 회사 환경에 따라 확인이 필요합니다.
S/4HANA 분석 스택과의 자리
라인 뷰 → 큐브 → 예정 뷰 → 분석 쿼리 → 서비스의 층 가운데 이 앱은 서비스 이후를 맡습니다. 데이터가 커지면 집계는 큐브 층에서 하고 화면은 한 번 읽은 큐브를 다시 묶는 방식을 유지합니다.
확장 포인트 — 운영에서 실제로 손대는 자리
| 자리 | 이유 |
|---|---|
| 클레임 원천 매핑 | 접수 · 청구 · 회수가 어느 문서에서 오는지는 회사마다 다름 — 확인 필요 |
| 회수 인식 시점 | 회수 확정을 어느 시점으로 볼지 회사 기준 |
| 예정(비교 기준) | 목표 클레임률과 단가를 어느 자료에서 가져올지 |
| 환율 유형과 기준일 | 환율 요인이 청구 금액과 맞아야 함 |
| 권한 | 집계 단계에서 회사코드 권한을 적용 |
분석 지표 정의표
| 지표 | 정의 |
|---|---|
| 청구액 | 클레임 수량 × 단가 × 환율 |
| 처리비용 | 검수 · 재작업 · 반송에 든 비용 |
| 회수액 | 공급사로부터 돌려받은 금액 |
| 순손실 | 청구액 + 처리비용 − 회수액 |
| 회수율 | 회수액 ÷ 청구액 |
| 클레임률 | 클레임 수량 ÷ 입고 수량 |
CDS 구성
아래는 같은 구조를 S/4HANA 에 만들 때의 스케치입니다. 이 화면은 검증용 샘플 데이터로 동작하며, 클레임 접수 · 회수 원천의 테이블과 표준 뷰 이름은 회사 환경에서 확인해야 해서 코드에 "확인 필요" 로 표시했습니다. 이름은 예시입니다.
뷰 레이어 구성
| 레이어 | 뷰 · 객체 | 하는 일 | 왜 나누나 |
|---|---|---|---|
| 기준 | ClaimTargets | 공급사 · 자재그룹별 목표 클레임률과 예정 환율 | 목표 갱신을 코드 변경 없이 반영 |
| 라인(기본) | ImportClaimLine | 접수 · 입고 · 회수를 잇고 라인별 비용 계산 | 드릴스루의 원천이며 비용식이 한 곳에만 있음 |
| 큐브 | ImportClaimCube | 차원 조합별 측정값 합산 | 집계 부하를 라인 조회와 분리 |
| 예정 | ImportClaimPlan | 같은 모양의 예정 값 | 칸마다 짝을 맞추고 요인분해를 가능하게 함 |
| 쿼리 | ImportClaimQuery | 필터 · 행 · 열 후보 선언 | 화면 범위와 데이터 범위를 분리 |
| 권한 | ImportClaimLine (DCL) | 회사코드 권한 적용 | 집계 단계에서 걸어 합계 추정을 막음 |
| 서비스 | ImportClaimService | OData 로 노출 | 화면 쪽 변경을 서비스 주소 교체로 한정 |
① 기준 테이블 — 목표 클레임률과 예정 환율
예정(비교 기준)을 코드가 아니라 표로 둡니다. 기준이 바뀔 때 뷰를 고치지 않아도 되고, 현업이 유지할 수 있는 자리입니다.
// ClaimTargets : 공급사 · 자재그룹별 예정 기준
// 역할 : 예정 수량 · 단가 · 환율 · 회수 비율의 출처를 표로 둔다.
@EndUserText.label : '수입 클레임 예정 기준'
define table claim_targets {
  key client      : abap.clnt not null;
  key supplier    : lifnr     not null;
  key material_grp: matkl     not null;
  key valid_from  : abap.dats not null;
  plan_rate       : abap.dec(9,5);   // 예정 환율 (확인 필요: 어느 환율 유형)
  plan_recovery   : abap.dec(5,4);   // 예정 회수 비율
  plan_claim_rate : abap.dec(5,4);   // 목표 클레임률
}
② 클레임 라인 뷰 — 비용을 한 줄에
접수 · 입고 · 회수를 라인 단위로 이어 청구 · 처리비 · 회수 · 순손실을 계산합니다. 드릴스루가 읽는 원천이며 비용식은 여기에만 있습니다.
define view entity ImportClaimLine
  as select from ClaimItem as i               // 확인 필요: 접수 원천
  inner join ClaimHeader as h on h.ClaimNo = i.ClaimNo
  left outer join ClaimRecovery as r on r.ClaimNo = i.ClaimNo and r.ItemNo = i.ItemNo
{
  key h.CompanyCode, key h.ClaimNo, key i.ItemNo,
  h.Supplier, i.Material, i.Plant, h.ClaimType, h.Disposition,
  i.ClaimQty, i.ReceivedQty,
  cast( i.ClaimQty * i.UnitPrice * h.ExchangeRate as abap.curr(15,0) ) as ClaimAmount,
  i.HandlingCost                                                      as HandlingAmount,
  coalesce( r.RecoveredAmount, 0 )                                    as RecoveredAmount,
  ( i.ClaimQty * i.UnitPrice * h.ExchangeRate + i.HandlingCost
    - coalesce( r.RecoveredAmount, 0 ) )                              as NetLoss
}
③ 분석 큐브 — 차원과 측정값
화면이 한 번 읽는 큐브입니다. 차원 조합마다 측정값을 합산하며 집계 방식을 어노테이션으로 선언합니다.
@Analytics.dataCategory: #CUBE
define view entity ImportClaimCube
  as select from ImportClaimLine
{
  key CompanyCode, key Period, key Supplier, key Material, key Plant,
  key ClaimType, key Disposition, key ClaimCurrency,
  @Aggregation.default: #SUM ClaimAmount,
  @Aggregation.default: #SUM HandlingAmount,
  @Aggregation.default: #SUM RecoveredAmount,
  @Aggregation.default: #SUM NetLoss,
  @Aggregation.default: #SUM ClaimQty,
  @Aggregation.default: #SUM ReceivedQty
}
④ 예정 뷰 — 실적과 같은 모양의 비교 기준
같은 키에 버전을 더한 모양이어야 칸마다 짝이 맞고 요인분해가 가능합니다. 예정이 없는 라인은 미계획 요인이 됩니다.
define view entity ImportClaimPlan
  as select from ClaimPlanLine join ClaimTargets on ... // 확인 필요
{
  key CompanyCode, key Period, key Supplier, key Material, key Plant,
  key ClaimType, key Disposition, key ClaimCurrency, key Version,
  PlanQty, PlanUnitPrice, PlanRate, PlanHandlingUnit, PlanRecoveryRatio
}
⑤ 분석 쿼리 — 화면에 보이는 범위
@Analytics.query: true
define view entity ImportClaimQuery
  as select from ImportClaimCube
{
  @AnalyticsDetails.query.axis: #FILTER CompanyCode,
  @AnalyticsDetails.query.axis: #ROWS   Supplier,
  @AnalyticsDetails.query.axis: #ROWS   ClaimCurrency,
  @AnalyticsDetails.query.axis: #COLUMNS Period,
  NetLoss, ClaimAmount, RecoveredAmount
}
⑥ 접근 제어 — 집계 단계에 건다
권한을 화면이 아니라 라인 뷰에 걸어야 합계 차이로 남의 숫자를 추정하는 일을 막습니다.
@EndUserText.label: '수입 클레임 회사코드 권한'
@MappingRole: true
define role ImportClaimLineAuth {
  grant select on ImportClaimLine
    where CompanyCode = aspect pfcg_auth( F_BKPF_BUK, BUKRS, ACTVT = '03' );
}
⑦ 서비스 정의 — 밖으로 내보내는 것
define service ImportClaimService {
  expose ImportClaimCube  as CubeSet;
  expose ImportClaimPlan  as PlanSet;
  expose ImportClaimLine  as ItemSet;
  // 변동 사유 · 레이아웃은 쓰기 가능한 별도 엔티티로 노출 (확인 필요)
}
운영 시점에 해야 할 일
| 일 | 하지 않으면 |
|---|---|
| 클레임 원천 매핑 확정 | 라인이 비거나 중복됨 |
| 회수 인식 시점 합의 | 회수액이 분기마다 달라짐 |
| 예정 기준 확정 | "예정이 왜 이 숫자냐" 가 반복됨 |
| 환율 유형과 기준일 | 환율 요인이 청구 금액과 안 맞음 |
| 권한 설계 | 합계 차이로 남의 숫자가 추정됨 |
| 성능 점검(건수 상한) | 큐브가 커지면 한 번 읽기가 느려짐 |
숫자를 믿을 수 있는가 — 검증 결과
검증용 샘플 3,753개 라인을 전수로 돌린 결과입니다.
| 대사식 | 검사 건수 | 차이 건수 |
|---|---|---|
| 라인 순손실 = 청구 + 처리비 − 회수 (실적) | 3,753 | 0 |
| 라인 순손실 = 청구 + 처리비 − 회수 (예정) | 3,382 | 0 |
| 큐브 합계 = 원천 라인 합계 (측정값 6종) | 6 | 0 |
| 요인 6종의 합 = 총차이 (전체 · 공급사 범위) | 2 | 0 |
| 피벗 총합 = 큐브 총합 (축 6가지 배치) | 6 | 0 |
| 드릴스루 칸 값 = 읽은 라인 합 (12칸) | 12 | 0 |
| 서비스 계약 자동 점검 | 41 | 0 |
예정이 없는 라인 371건(272,864,331원)은 오류가 아니라 의도적 예외로 미계획 요인에 분리했으며 위 차이 건수와 별개입니다.
운영 데이터로 갈 때
건수가 커지면 큐브 읽기 상한과 페이지 크기를 다시 정해야 하고, 드릴스루는 기본 500행씩 읽는 방식을 유지합니다. 실제 응답 시간은 이 샘플에서 측정한 값이 아니므로 운영 규모에서 다시 확인해야 합니다.
자주 묻는 질문
도입을 검토할 때 자주 나오는 질문을 네 묶음으로 모았습니다.
숫자와 산식
순손실은 어떻게 계산하나요?
청구액에 처리비용을 더하고 회수액을 뺍니다. 청구액은 수량 × 외화 단가 × 환율입니다. 샘플의 단가와 환율은 가정값입니다.
회수율과 클레임률은 어떻게 정의하나요?
회수율은 회수액 ÷ 청구액, 클레임률은 클레임 수량 ÷ 입고 수량입니다. 둘 다 계산항목으로 정의되어 보드에서 바로 쓸 수 있습니다.
외화와 환율은 어떻게 처리하나요?
청구 통화별 환율을 곱해 원화로 바꾼 값으로 합산하며 서로 다른 통화를 그대로 더하지 않습니다. 어느 날짜의 환율을 쓸지는 운영 시점에 정할 일이며 확인 필요입니다.
칸의 숫자를 믿을 수 있는지 어떻게 확인하나요?
칸을 누르면 클레임 라인이 열리고 머리에 칸의 값과 읽은 라인의 합이 함께 나옵니다. 검산 패널은 큐브 합계와 라인 합계를 측정값마다 나란히 놓으며 샘플에서는 모두 차이가 0 입니다.
예정(비교 기준)은 어디서 오나요?
샘플에서는 라인마다 예정 수량 · 단가 · 환율 · 처리비 · 회수 비율을 가진 예정 데이터입니다. 운영에서는 회사가 정한 기준에서 가져와야 하며 도입 때 가장 먼저 정할 일입니다.
요인분해는 어떻게 합이 총차이와 같아지나요?
라인마다 예정 값을 실적 값으로 한 요인씩 순서대로 바꿔 가며 금액 변화를 요인에 배정합니다. 한 번에 하나만 바꾸므로 교차항이 따로 남지 않고, 예정 없는 라인은 통째로 미계획 요인입니다. 순서를 바꾸면 요인별 배분은 달라질 수 있어 회사 관행과 맞는지 확인이 필요합니다.
미계획 요인은 무엇인가요?
예정 데이터에 짝이 없는 라인의 순손실 전체입니다. 샘플에서는 371건, 272,864,331원입니다.
화면과 조작
조회조건에서 꼭 넣어야 하는 것은 무엇인가요?
회사코드와 시작 · 종료 접수월입니다. 차원 값은 선택이며 비우면 전체입니다.
행과 열 축은 몇 단계까지 쓸 수 있나요?
행 축은 최대 3단계, 열 축은 최대 2단계입니다. 열 조합이 36개를 넘으면 앞쪽만 보여 주고 범위를 좁히라고 안내합니다.
축을 바꿀 때 서버를 다시 부르나요?
아닙니다. 조회 때 한 번 읽은 큐브를 브라우저에서 다시 묶습니다. 자동 점검에서 축 6가지 배치의 재조회 요청은 0건이었습니다.
레이아웃은 어디에 저장되나요?
축 · 조회조건 · 표시 항목을 이름 붙여 서비스에 저장하므로 새로 고침 뒤에도 같게 보입니다. 기본 레이아웃과 열 때 자동 조회를 지정할 수 있습니다.
내려받기는 무엇을 지원하나요?
피벗과 원천 라인 목록은 CSV 로, 현재 범위의 표와 차트는 PowerPoint 보고서로 내려받습니다.
모바일에서도 쓸 수 있나요?
좁은 화면에서는 차트가 표 아래로 쌓이고 가로 스크롤이 생기지 않도록 점검했습니다. 열이 많으면 범위를 좁히라는 안내가 나옵니다.
분석 기능
AI 분석은 숫자를 만드나요?
아닙니다. 금액과 비율은 서비스가 큐브에서 계산하고 해설은 그 값을 문장으로 옮길 뿐입니다. 기본은 모델이 연결되지 않은 규칙 기반이며 모델 연결은 서비스 설정에서만 켜고 기본은 꺼짐입니다.
AI 에이전트는 무엇을 하고 왜 하루 한 번인가요?
감시 규칙 다섯 가지(클레임률 상한, 환율 영향, 회수율 하한, 처리비 초과, 미회수 잔액)를 돌려 걸린 건을 대기함에 올립니다. 같은 보고가 반복되어 대기함이 넘치는 것을 막으려고 실행은 하루 한 번으로 제한합니다.
변동 사유는 어떻게 남고 어디까지 따라오나요?
사유의 키는 조회 범위와 행 경로입니다. 같은 행이면 축을 바꿔도 따라오고 새로 고침 뒤에도 남습니다.
계산항목은 직접 추가할 수 있나요?
샘플에는 다섯 항목이 서비스에 정의되어 있고 토큰 식으로 되어 있습니다. 운영에서 항목을 늘리는 방법은 서비스 구성에 따르며 확인 필요입니다.
검토용 자료는 무엇인가요?
왼쪽 목차의 "검토용 자료 다운로드" 는 이 글의 내용과 화면을 브라우저에서 PowerPoint 파일로 묶어 줍니다. 별도 라이브러리나 서버 전송 없이 만들어집니다.
도입과 운영
이 화면의 결과를 회계 판단의 최종 근거로 써도 되나요?
이 화면은 집계와 대사를 돕는 점검 도구입니다. 최종 판단은 회사와 감사인이 하고, 법정 · 감사 대응 숫자는 표준 전표 기준으로 유지해 주세요.
권한은 어디에 거나요?
화면이 아니라 집계 단계(라인 뷰)에 회사코드 권한을 겁니다. 그래야 합계 차이로 남의 숫자를 추정하지 못합니다.
데이터가 아주 많으면 어떻게 되나요?
큐브 읽기 상한과 드릴스루 페이지 크기를 운영 규모에 맞게 다시 정해야 합니다. 응답 시간은 샘플에서 측정한 값이 없어 확인 필요입니다.
데모는 어디서 볼 수 있나요?
왼쪽 목차의 "데모 열기" 에서 샘플 데이터로 동작하는 화면을 열 수 있습니다.
도입 전에 가장 먼저 정할 일은 무엇인가요?
클레임 원천 매핑, 회수 인식 시점, 예정(비교 기준)의 출처 세 가지입니다. 코딩보다 합의가 먼저입니다.